线程安全、原子变量、内存顺序
五月 06, 2024 [C/C++] #C++ #obsidian #安全 #并发 #操作系统原理线程安全、原子变量、内存顺序
本文是阅读 Rust Atomics and Locks 这本书的笔记。这本书是我看过讲原子变量最浅显易懂的资料了。
本来想简单写的,但发现写着写着就抄得差不多了,只能说忽略了很多内容和细节。
如果有什么理解错误,请大家多多包涵并指出~
线程安全
为了高性能,我们几乎无法避免编写多线程的程序。而多线程的环境相比于单线程来说,有更多更复杂的限制和要求,其中最重要的便是线程安全。
线程安全是一个开放性的概念,如果一个程序能满足与多线程相关的各种要求,那么这个程序便是线程安全的,这时候的程序不会出现预期外的行为。而这里有哪些“要求”在不同语言、不同平台、不同接口各有不同,无法用有限的规则来描述。
Rust将线程安全的要求大致分成了两类Send和Sync,只有满足这两类要求的API,才能在多线程的环境下安全的调用(以外的就只能在unsafe下调用)。Swift则只有Sendable这一选项,不过存在感很低。而cpp没有任何任何静态检查保证线程安全。
线程安全比较常见的要求有:
- 有些系统API要求在同一个线程内调用。比如
pthread_mutex_lock/pthread_mutex_unlock要求在同一线程内调用,https://pubs.opengroup.org/onlinepubs/009695399/functions/pthread_mutex_lock.html。 - 多线程内存读写,一般要求不能出现数据竞争。也就是不允许(非原子操作)对同一内存的并发读和写,或者同时写。
其中数据竞争,是在多线程编程中最普遍的问题。我们可以通过线程同步来避免数据竞争。线程同步就是一些协议或者说是一些措施,来保证多线程下语句之间的顺序关系,最终可以证明一片内存不会被并发读写。一般来说,线程同步的方式有这些:
- 各种各样的线程同步原语(系统提供或者用户自己实现):锁、信号量、条件变量、屏障(barrier)等
- 原子变量操作的内存顺序(memory order)(需要特定硬件和平台支持)
其中线程同步原语一般是靠线程的休眠和唤醒,使某些代码会在达成某个条件后才执行。线程的休眠和唤醒会产生一定的开销,在一些高频或高并发但比较轻量的场景下,这些开销会被放大,这时候可以考虑是否可以使用原子变量来实现些非阻塞性(lock-free)的算法,或者自己实现一些更细粒度的并发控制结构以减少线程休眠唤醒的次数。
原子变量的操作是原子性的,本身允许并发读写,就一些简单的场景(例如原子计数)甚至不需要进行线程同步。同时原子变量还具有非阻塞性,不会产生线程休眠唤醒的开销。在一些可以无锁或者比较“乐观”的并发场景,可以使用原子变量来实现,比如说一些无锁队列,相对于有锁的队列来说可以带来更多的性能提升。
一般的线程同步原语都比较好理解,而原子变量的内存顺序却相对来说比较生涩难懂,本文打算展开一下后者,帮助大家理解。
对数据竞争这一概念的补充。 数据竞争是一种程序的非法状态。绝大多数程序语言都不会定义程序并发读写/写写同一内存的行为(原子变量例外),也就是所谓未定义行为。 当(抽象地,利用语言定义的规则像算术那样计算)解释的代码并发读写同一内存时,就会陷入“数据竞争”的状态,接下来的解释将没有任何意义(就好像计算过程中产生了一个1/0一样)。当然其编译器也就不会保证程序数据竞争时会有任何预期而当行为(比如引爆核弹)。 至于为何绝大多数语言都有这条规定,主要还是现代OS和机器机制太复杂了(多核、指令重排、缓存等等),本身就很难描述并发时计算机的状态,而且各家还有各家的玩法,还要考虑到高级程序语言中一句简单的语句就会编译成复杂的汇编指令,复杂度更是暴增。于是大家就索性不规定程序并发读写/写写同一内存的行为(除非头铁,规定所有操作必须加锁),由程序员自己去避免。 那么这里请问大家,这段代码会发生数据竞争吗?
static mut A: i32 = 0;
fn thread_a() {
      unsafe { A += 1; }
}

fn thread_b() {
      sleep(Duration::from_secs(10));
      println!("{A}");
}

fn main() {
      thread::spawn(thread_a);
      thread::spawn(thread_b);
      thread::park();
}
原子变量
本文主要想介绍的便是原子变量、原子操作,以及原子操作的几种内存顺序。(本文基于的原子变量模型,是c++20原子变量模型,而例子使用Rust语言)。
原子变量,它首先是一类可以提供原子性操作的对象(于是允许并发读写),同时也是与其他线程同步原语一样也是一种用来描述多线程下操作顺序关系的模型。
注意:这只是一种抽象的内存模型,并不直接映射到实际的内存与实际的指令中,也不考虑各种编译优化。是一种最低限度但明确的假设;反过来也可以要求编译器、OS、硬件满足这个假设。
原子变量的模型,由三部分组成:
原子类型:AtomicU8, AtomicBool, AtomicI32, AtomicPtr,等等。不同的平台(硬件+OS)决定着哪些原子类型是可用的,一般来说,最大的原子类型为指针大小的原子类型。
原子操作:
- 最简单的加载和存储:
load,store - 稍复杂的获取修改(fetch-and-modify):
fetch_add,fetch_or等等, - 最灵活和复杂的是比较交换:
compare_exchange
内存顺序:用于建立线程间原子操作的发生顺序。比如
Relaxed几乎没有任何顺序保证,几乎只有原子性。SeqCst则有最强的保证。所有SeqCst的原子操作之间有一个全局唯一的全序关系。
每个原子操作都会有至少一个内存顺序的参数。
原子操作
这一节介绍几种原子操作,我们先忽略掉内存序这个参数(全部使用最简单的Relaxed内存序),仅看原子操作的行为。
加载和存储
加载(load)和存储(store)是最基础的的两个原子操作。load是原子地获取原子变量的变量的值,store是原子地修改原子变量的值。这两个操作的函数签名是:
impl AtomicI32 {
    pub fn load(&self, ordering: Ordering) -> i32;
    pub fn store(&self, value: i32, ordering: Ordering);
}
其中ordering便是内存顺序的参数,在后文展开。
例子:
fn main() {
    let atomic = AtomicI32::new(0);

    // 并发写入 1或2或3
    thread::scope(|s| {
        s.spawn(|| {
            atomic.store(1, Relaxed);
        });

        s.spawn(|| {
            atomic.store(2, Relaxed);
        });

        s.spawn(|| {
            atomic.store(3, Relaxed);
        });
    });

    // 输出最后一个写入的数字,1或2或3
    println!("{}", atomic.load(Relaxed));
}
获取和修改操作
获取和修改(fetch and modify),可以看做是a += b这类操作的原子化版本。对于AtomicI32来说,就有这些:
impl AtomicI32 {
    pub fn fetch_add(&self, v: i32, ordering: Ordering) -> i32;
    pub fn fetch_sub(&self, v: i32, ordering: Ordering) -> i32;
    pub fn fetch_or(&self, v: i32, ordering: Ordering) -> i32;
    pub fn fetch_and(&self, v: i32, ordering: Ordering) -> i32;
    pub fn fetch_nand(&self, v: i32, ordering: Ordering) -> i32;
    pub fn fetch_xor(&self, v: i32, ordering: Ordering) -> i32;
    pub fn fetch_max(&self, v: i32, ordering: Ordering) -> i32;
    pub fn fetch_min(&self, v: i32, ordering: Ordering) -> i32;
    // 返回当前值,并替换为`v`
    pub fn swap(&self, v: i32, ordering: Ordering) -> i32;
}
比如fetch_add就是在原子变量上上加v,并返回原来的值:
let a = AtomicI32::new(100);
let b = a.fetch_add(23, Relaxed);
let c = a.load(Relaxed);

assert_eq!(b, 100);
assert_eq!(c, 123);
例子:
fn main() {
    let a = AtomicI32::new(0);

    // 并发+1
    thread::scope(|s| {
        // 100个线程都对a +1
        for _ in 0..100 {
            s.spawn(|| {
                a.fetch_add(1, Relaxed);
            })
        }
    });

    assert_eq!(a.load(Relaxed), 100);
}
比较交换
最灵活但最灵活的原子操作是比较交换操作(compare_exchange)。它的签名是:
impl AtomicI32 {
    pub fn compare_exchange(
        &self,
        expected: i32,
        new: i32,
        success_order: Ordering,
        failure_order: Ordering
    ) -> Result<i32, i32>;
}
其行为是:
- 如果原子变量的值为
expected,那么将原子变量的值替换为new,返回Ok(旧值)。这部分的行为和atomic.swap(new, success_order)一致。 - 如果不一致,则返回
Err(当前值)。失败的行为和atomic.load(failure_order)一致。
let a = AtomicI32::new(100);
// 替换成功
let b = a.compare_exchange(100, 0, Relaxed, Relaxed);
// 替换失败
let c = a.compare_exchange(100, 1, Relaxed, Relaxed);

assert_eq!(b, 100);
assert_eq!(c, 0);
虽然很复杂,但它确实是一个原子操作。
内存顺序
原子变量中真正用于线程同步的部分是内存顺序,用于建立线程间原子操作的发生顺序。这个操作之间的顺序关系称为Happens-Before关系。
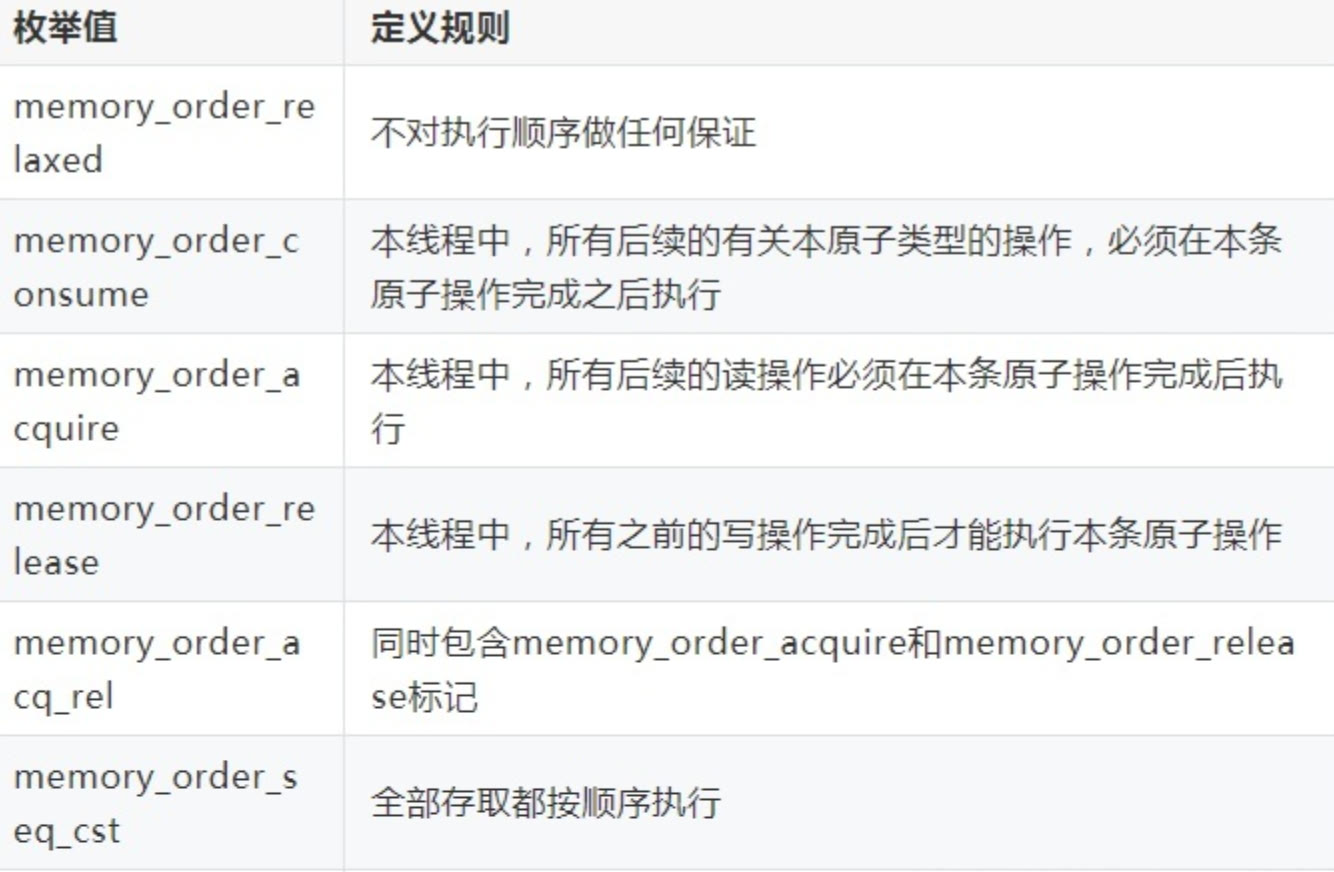
而目前cpp的内存模型里定义了这几个内存顺序,对应着建立不同Happens-Before关系的规则:
- 宽松顺序:
Relaxed - 释放获取顺序:
Release,Acquire,AcqRel - 消费顺序(但目前没有编译器能正确实现,rust里则直接忽略了,cpp建议不使用,是一种弱化版的释放获取顺序)
- 序列一致顺序(Sequentially consistent ordering):
SeqCst
Happens-Before关系
Happens-Before关系,描述的便是操作发生的顺序。我们用 HB(x,y) \mathit{HB}(x, y) 记号表示,操作x发生于操作 y之前(happens before),这个关系满足传递性。两个语句一旦形成Happens-Before关系,则意味着他们不是并发执行的,因为后一个操作可以完整地看到前一个操作做完后的状态。
但要注意的是,Happens-Before与时序无关,比如允许两个操作之间有无限长的时间(比如缓存一直不同步回内存里),也允许一些反直觉的行为出现。
最基本的Happens-Before关系,便是单个线程中语句的求值顺序:比如{ stmt1; stmt2; stmt3; },这里就蕴含着三个happens before关系, HB(stmt1,stmt2) \mathit{HB}(stmt_1, stmt_2) , HB(stmt2,stmt3)\mathit{HB}(stmt_2, stmt_3) ,根据传递性又可以得到 HB(stmt1,stmt3)\mathit{HB}(stmt_1, stmt_3) 。
而在多个线程之间,需要通过线程同步来确立Happens-Before关系,比如互斥锁不同线程的unlock和lock可以形成Happens-Before关系 HB(unlock,lock) \mathit{HB}(unlock, lock) :
fn thread_a(mutex: &Mutex<bool>) {
    let guard = mutex.lock().unwrap(); // lock_a
    *guard = true; // 1
    drop(guard); // unlock_a
}

fn thread_b(mutex: &Mutex<bool>) {
    let guard = mutex.lock().unwrap(); // lock_b
    println!("{}", *guard); // 2
    drop(guard); // unlock_b
}
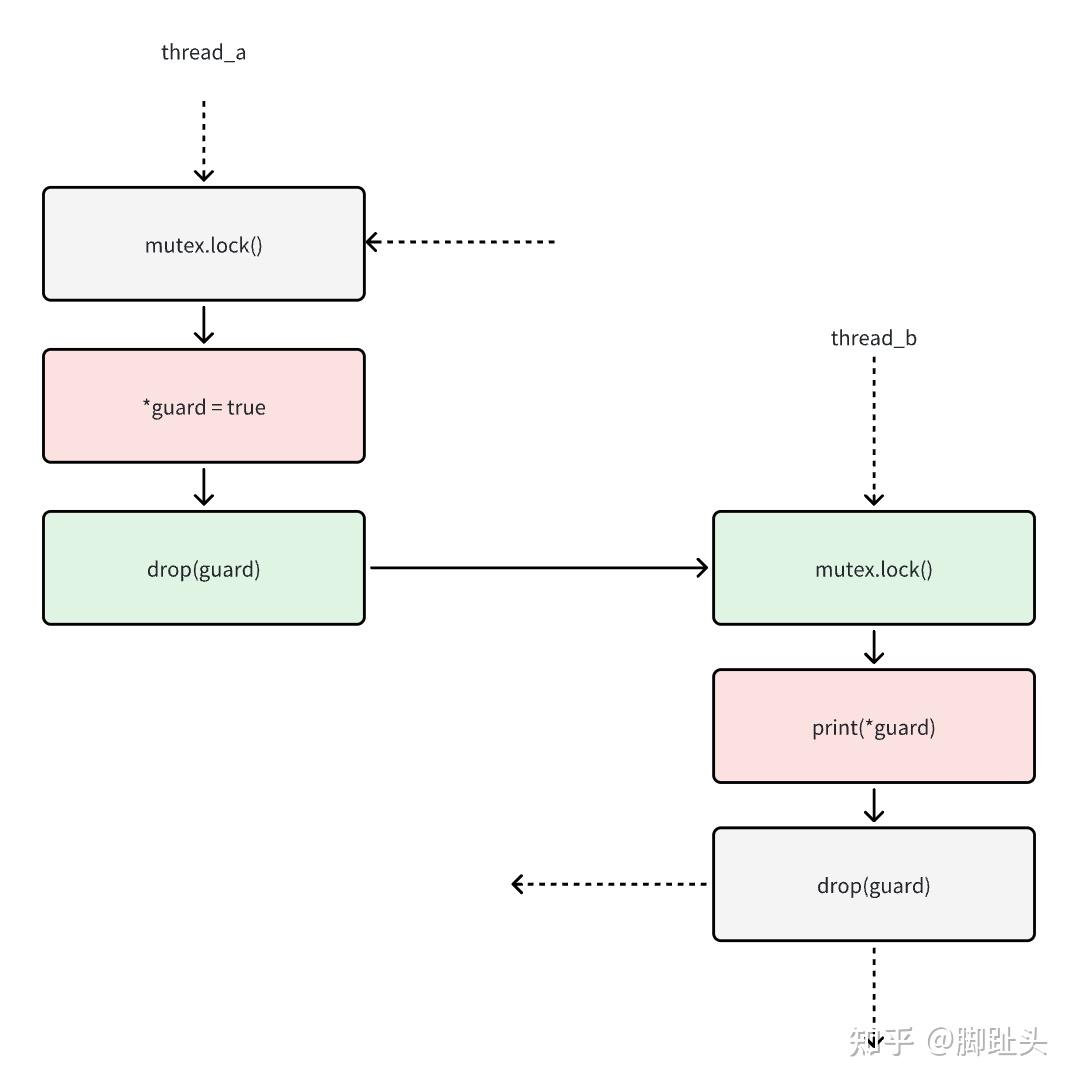
- 在
thread_a里有Happens-Before关系: HB(1,unlocka) \mathit{HB}(1, unlock_a) - 在
thread_b里有Happens-Before关系: HB(lockb,2) \mathit{HB}(lock_b, 2) unlock_a和lock_b可以形成Happens-Before关系: HB(unlocka,lockb) \mathit{HB}(unlock_a, lock_b)- 于是根据传递性可以得到: HB(1,2) \mathit{HB}(1, 2) 。
- 进一步推导,可以获得任何在锁里执行的语句,都能形成Happens-Before关系,那么意味着锁里的代码不会被并发执行。
不过Happens-Before关系仅仅只是个抽象,并不一定对应实际操作发生的顺序。现实的情况就是,如果编译器发现一些Happens-Before关系也不会影响程序最终的行为,那么编译器就会选择去掉它,并做一些优化,比如指令重排(交换指令执行顺序,甚至并发执行)和缓存(写内存的语句,可以先写到某个缓存里,之后在某个时刻才同步到内存里)
比如指令重排的一个例子:
fn f(a: &mut i32, b: &mut i32) {
    *a += 1; // 1
    *b += 1; // 2
    *a += 1; // 3
}
编译器发现语句1,2,3的Happens-Before关系不重要,可以去掉,那么意味着语句1,2,3的顺序可以交换(甚至可以并发执行),那么编译器就可以做这样的优化:
fn f(a: &mut i32, b: &mut i32) {
    *a += 2;
    *b += 1;
}
其实现代的CPU同样也会做这样的优化。
宽松内存序
宽松内存序是最弱的内存序,Relaxed仅仅保证了操作的原子性,不会保证线程间操作发生的顺序,比如:
fn main() {
    let a = AtomicI32::new(0);

    thread::scope(|s| {
        s.spawn(|| {
           a.store(100, Relaxed);
        });

        s.spawn(|| {
            sleep(Duration::from_secs(100));
            // 这里可能会失败,a也可能永远读不到最新的100。
            // 因为现在没有任何规则能够说明a.load(Relaxed)发生在a.store(100, Relaxed)之后
            assert_eq!(a.load(Relaxed), 100);
        })
    });
}
甚至还会有“无中生有”的情况发生(原子变量的模型中这种情况是没法避免的的https://en.cppreference.com/w/cpp/atomic/memory_order#Relaxed_ordering,但cpp标准不允许会会有无中生有的实现),
fn main() {
    let x = AtomicI32::new(0);
    let y = AtomicI32::new(0);

    thread::scope(|s| {
        // 线程1:读x,把x的值写入y中。
        s.spawn(|| {
            let x = x.load(Relaxed);
            y.store(x, Relaxed);
        });

        // 线程2:读y,把y的值写入x中。
        s.spawn(|| {
            let y = y.load(Relaxed);
            x.store(y, Relaxed);
        });
    });

    // 此时x和y的值允许是任意值
    // 这个断言允许失败
    assert_eq!(x.load(Relaxed), 0);
    // 这个断言允许成功
    assert_eq!(y.load(Relaxed), 42);
    // 这个断言必定成功
    assert_eq!(x.load(Relaxed), y.load(Relaxed))
}
这里只有两个Happens-Before关系
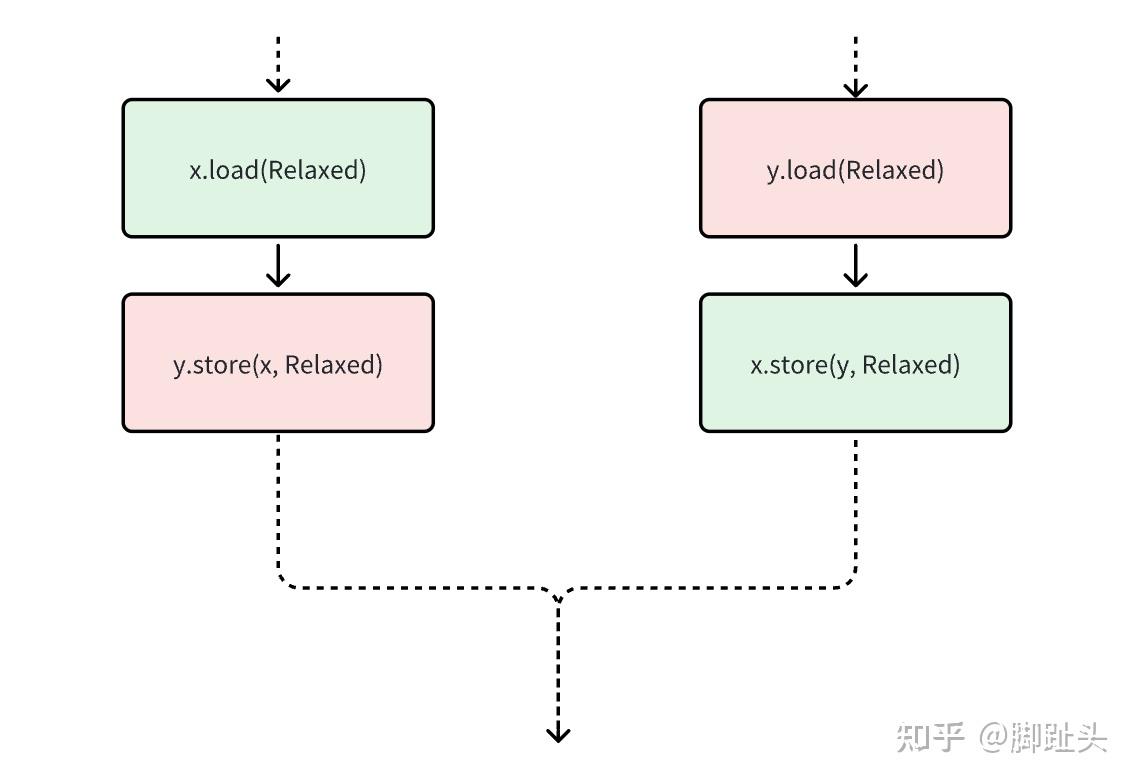
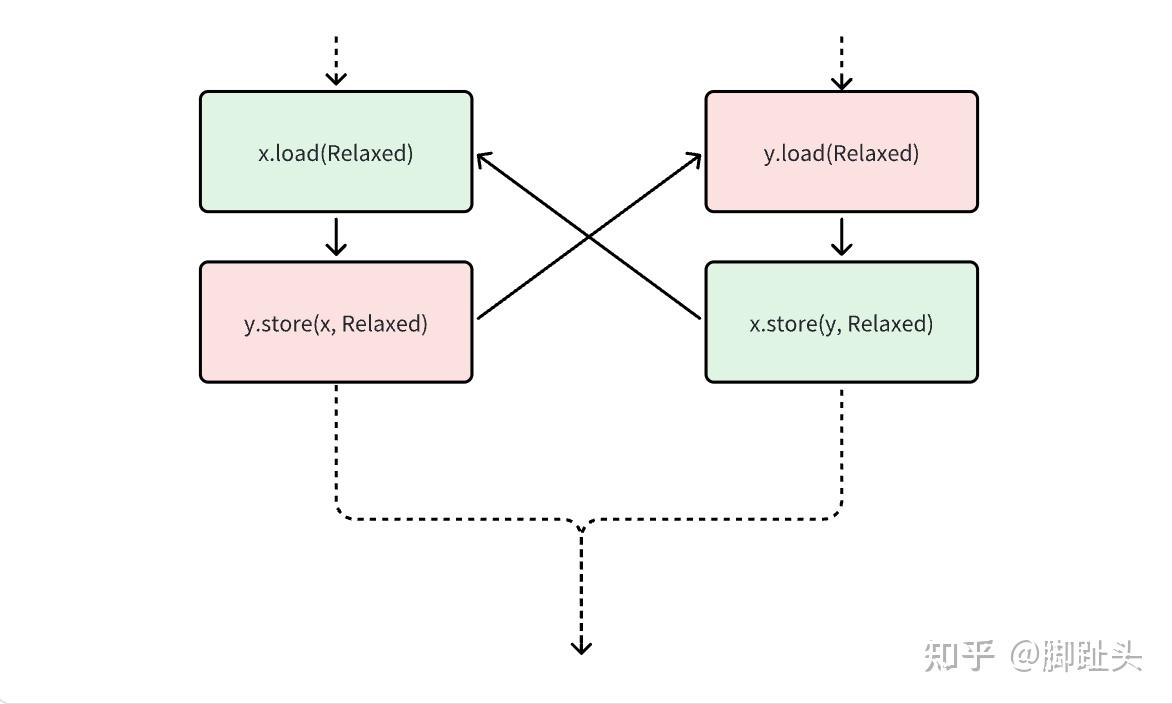
因为缺乏线程间的Happens-Before关系,这里的两条load语句,我们可以假设读到的是另外一个线程store的结果,这时候我们只能得到方程x == y,而这条方程的解就可以是i32的任意值。
释放获取内存序
释放(Release)和获取(Acquire)是用得最多的内存序,成对使用时就可以在线程之间形成Happens-Before关系。其规则如下
Release内存序用于store操作(或者其它原子操作修改的部分)Acquire内存序用于load操作(或者其它原子操作中读取的部分)- 当使用
Acquire的原子操作读取到Release原子操作写入的结果时,就可以形成一个Happens-Before关系, HB(storeRelease,loadAcquire) \mathit{HB}(store_{Release}, load_{Acquire}) .
例子,初始化和读取分为两个线程:
static mut DATA: u64 = 0;
static INIT_FLAG: AtomicBool = AtomicBool::new(false);

// init thread
fn thread_a(x: u64) {
    unsafe { DATA = x } // init
    // 初始化完毕置`INIT_FLAG`为true
    INIT_FLAG.store(true, Release);
}

// read thread
fn thread_b() -> u64 {
    // 等待初始化标志置为true
    while !INIT_FLAG.load(Acquire) {

    }
    return DATA; // read
}
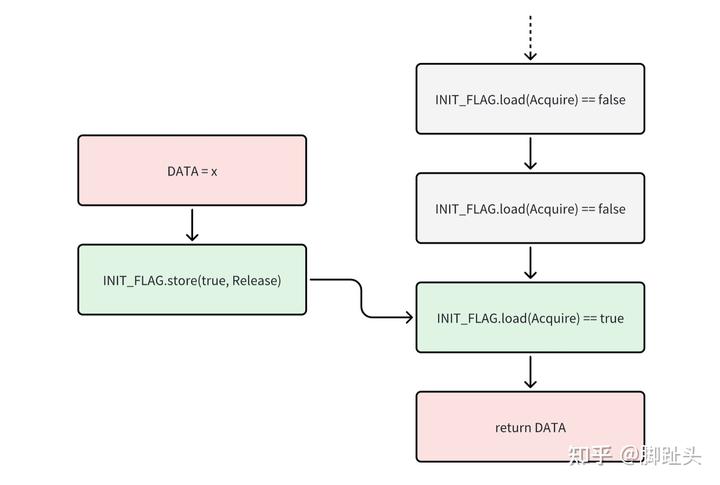
不过这里有个现象,如果有两个线程都用Release序给原子变量写入同一个值时,Acquire读到这个值时,究竟是和哪个线程建立了Happens-Before关系呢?答案是,如果没有其它条件加以区分的时候,你只能知道是和其中一个线程的Release写形成了Happens-Before关系,但无法区分是哪一个。
敏锐的你可能发现,释放获取内存序好像也允许无中生有的情况:
fn foo(any: i32) {
    let x = AtomicI32::new(0);
    let y = AtomicI32::new(0);

    thread::scope(|s| {
        s.spawn(|| {
            // 与4发生Happens-Before关系
            assert_eq!(x.load(Acquire), any); // 1
            y.store(x, Release); // 2
        });

        s.spawn(|| {
            // 与2发生Happens-Before关系
            assert_eq!(y.load(Acquire), any); // 3
            x.store(y, Release); // 4
        });
    });
    assert_eq!(x.load(Relaxed), any);
    assert_eq!(y.load(Relaxed), any);
}
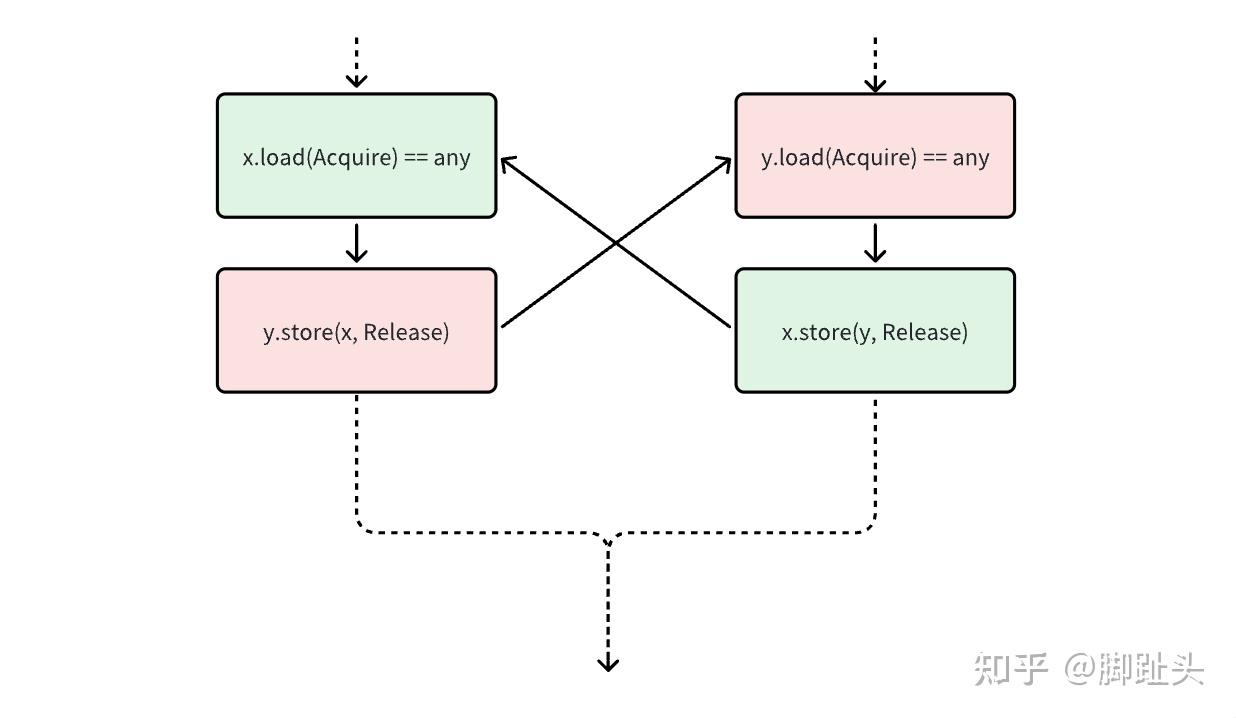
但事实上不允许,内存模型其实还有其他的规定https://en.cppreference.com/w/cpp/atomic/memory_order#Modification_order,规定了形成Happens-Before关系的原子操作之间的读写一致性……
序列一致内存序
序列一致(Sequentially consistent ordering)的内存序是最强的内存序,严格强于释放获取内存序
- 它用于
store时(或者是其它原子操作的写入部分),相当于Release(也可以和Acquire建立关系); - 而用于
load时(或者是其它原子操作的读取部分),则相当于Acquire(也可以和Release建立关系); - 同时还保证所有使用
SeqCst原子操作之间的Happens-Before关系是全序的(数学上的total order),并且这个全序关系全局唯一。
第三条规则就像它的名字一样,用SeqCst表达的原子操作是一个序列(Sequential),可以将一个个原子操作放在时间轴上,所以也是最符合直觉、最好分析的一个顺序。
其实这里也只是简化版的说法
SeqCst内存序是最好推理的内存序,但对应到底层实现,它也是最“贵”的内存序。不过绝大多数情况我们都不需要这么强的内存顺序,很多时候换成对应的Acquire和Release都成立。
原子变量应用
本节囿于篇幅还是实现个简单的自旋互斥锁吧。
一些更强大的并发结构,可以参考crossbeam库。
接口
接口参考std的互斥锁,这是一套锁的几乎最简洁的接口了:
/// 自旋互斥锁,保护一个`T`的值
pub struct SpinMutex<T> {
    /// 是否上锁了
    locked: AtomicBool,
    /// 被保护的数据(先忽略UnsafeCell)
    data: UnsafeCell<T>,
}

/// 获得锁后,数据的一个“句柄”,句柄退出作用域后释放锁
/// 即cpp中的RAII,swift中的defer
pub struct SpinMutexGuard<'a, T>(&'a SpinMutex<T>);

impl SpinMutex<T> {
    /// 创建一个带数据的锁
    pub fn new(data: T) -> Self;

    /// 获取锁的接口
    pub fn lock(&self) -> SpinMutexGuard<T>;

    /// 一个线程独占锁的时候就可以直接获取内部的数据
    pub fn into_inner(self) -> T;
}

impl SpinMutexGuard<'_, T> {
    /// 通过guard访问T
    fn as_ref(&self) -> &T;
    /// 获得锁之后就可以修改T了
    fn as_mut(&mut self) -> &mut T;
}

/// 当SpinMutexGuard<T>析构之后就会自动释放锁
impl Drop for SpinMutexGuard<'_, T> {
    fn drop(&mut self);
}

// 下面的这些是关于线程安全的一些约束
unsafe impl<T: Send> Send for SpinMutex<T>;
unsafe impl<T: Send> Sync for SpinMutex<T>;
unsafe impl<T> !Send for SpinMutexGuard<'_, T>;
unsafe impl<T: Sync> Sync for SpinMutexGuard<'_, T>;
用例
fn main() {
    // 保护一个String的数据
    let m = SpinMutex::new("123".to_string());

    thread::scope(|s| {
        // 线程1
        s.spawn(|| {
            // 取锁
            let guard = m.lock();
            // 获取锁后拼接"abc"
            *guard.as_mut() += "abc";
            // 睡眠1s,模拟耗时操作
            sleep(Duration::from_secs(1));
        }); // 作用域退出后释放锁

        s.spawn(|| {
            // 取锁 获取数据 释放锁
            let data = *m.lock().as_ref();
            println!("{data}");
        })
    });

    // 主线程在子线程退出后独占锁,然后可以把里面的数据取出来
    let s = m.into_inner();
    // ..其它操作
}
实现
其中核心就是锁的获取和释放,其中获取锁的过程是使用一个循环不断地轮询locked字段,这种循环叫做spin loop。当然spin loop会浪费一些cpu cycle,只适用于非常乐观的情况,其它互斥锁的实现会替换为“线程挂起”操作。
impl SpinMutex<T> {
    /// 获取锁的接口
    pub fn lock(&self) -> SpinMutexGuard<T> {
        // 尝试加锁,也就是将把locked置为true
        // 如果locked为false,则加锁成功,返回guard
        // 否则一直循环
        while self.locked.swap(true, Acquire) { // 1
            // 告诉编译器这里是一个spin loop,可以优化
            std::hint::spin_loop();
        }

        SpinMutexGuard(self)
    }
}

impl Drop for SpinLockGuard<'_, T> {
    // 释放锁
    fn drop(&mut self) {
        self.0.locked.store(false, Release); // 2
    }
}
- 这里
swap操作用Acquire序,即获取里面的locked值的时候用Acquire,如果读到是false,就可以和2的Release形成一个Happens-Before关系 store操作使用Release序写入false。
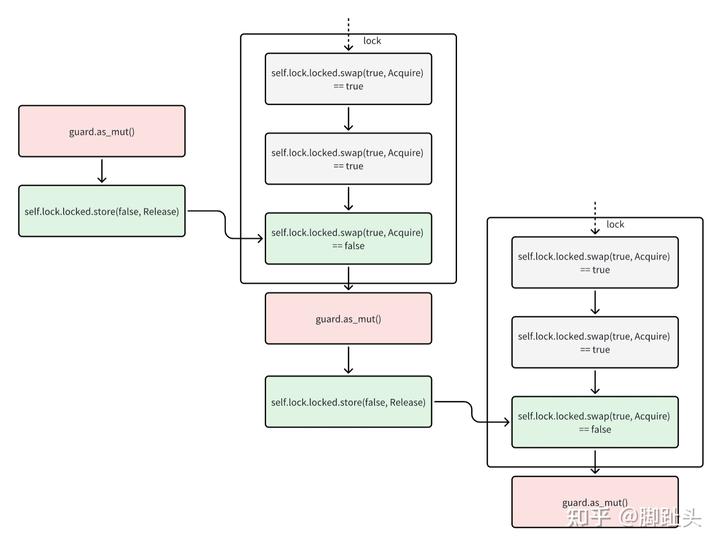
其实这里也隐含了lock/unlock必须要在同一个线程里调用的条件。
那么因为获取锁之后,可以保证别的地方不再访问该数据,所以可以通过guard来访问T
impl SpinMutexGuard<'_, T> {
    fn as_mut(&mut self) -> &mut T {
        // Safety:
        // 上锁了之后可以保证只有当前线程能访问数据,所以可以安全地返回&mut T
        unsafe { &mut* self.lock.data.get() }
    }
}
这算是十分简单的接口了。当接口复杂起来,就不能这么简单地分析了。比如rust标准库里的scoped thread也曾因为没注意一些微小的区别导致data race https://github.com/rust-lang/rust/issues/98498,有意思的是,这个bug是通过rust的MIRI跑出来的(一个基于rust MIR的一个解释器,可以用来发现代码中的未定义行为)
其实线程同步原语,背后其实也是由原子变量(以及一些线程的操作)所实现的,是一些线程同步模式的封装。不过同是一类同步原语,系统做的和用户自己实现的效果和开销也各不相同,比如系统提供的锁可能会因为内核态到用户态的切换导致开销 会比 单纯在用户态实现的锁开销更大。 而大多数没有lock-free算法或者wait-free算法的情况下,用原子变量实现的线程同步效果,不过又是在靠近业务的地方又实现了一把更细粒度的锁,是否真的比系统提供的锁更快,还真的不一定。 另外单线程也未必比多线程更慢,因为单线程能更好地利用缓存,程序相对来说更好设计;而多线程有几乎不能避免的线程同步开销(这个开销甚至是主要开销),而且多线程的复杂度十分难控制,写出高性能程序的难度也更大。 但总之,对于性能的优化,一定还是需要通过足够的profile,才能确定哪种优化的更优,尤其在多线程的环境下
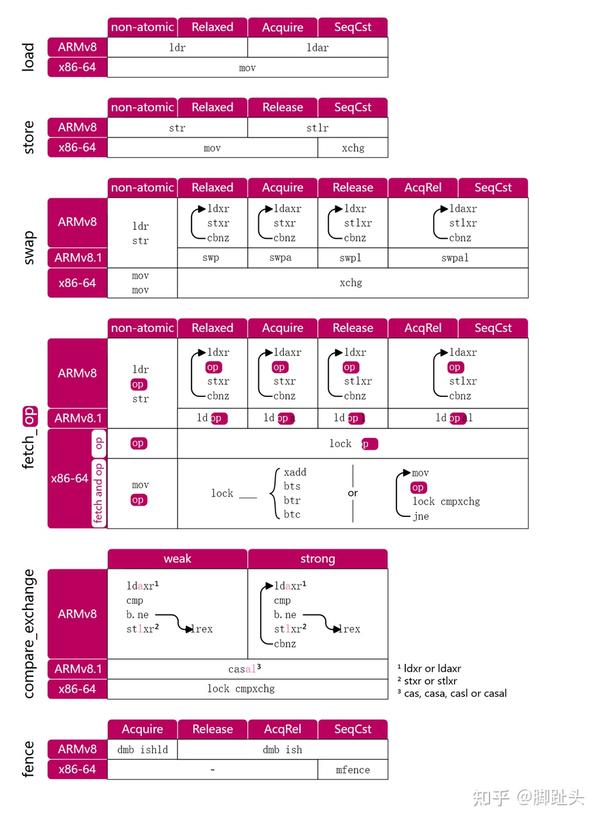
原子变量的底层实现
直接一图流:
总结
- 无数据竞争是线程安全的必要条件
- 通过线程同步来保证无数据竞争;
- 线程同步本质就是规定线程间语句的顺序关系(Happens-Before关系)
- 互斥锁通过unlock/lock建立Happens-Before关系;而原子变量的操作通过内存顺序建立线程间Happens-Before关系
- 原子变量结合线程操作(挂起、唤醒)实现更多的线程同步原语
- 原子变量(及操作)在不同硬件上实现不一样,但一般都比非原子的版本开销大