串口线悬空带来的灾难:定位一次意想不到的Linux系统崩溃
七月 09, 2024 [Linux 与系统] #Linux #obsidian #嵌入式 #操作系统原理串口线悬空带来的灾难:定位一次意想不到的Linux系统崩溃
导语: 你相信吗?悬空的串口线可以导致reboot失败、systemd挂起、僵尸进程累积,最终导致Linux系统崩溃,一起来看看这个听起来就格外玄幻的故事。
【问题现象】
自研交换机作为鹅厂的重要基础设施,广泛的服务于DCI、DCN等数据中心场景。设备数量多了自然会遇到一些神奇的故障。最近一个月就连续遇到了两例僵尸进程堆积的灵异故障。
案例1: 安装 XXX_HOT_P05 补丁失败,upgraded 卡在 klp_manage服务
故障现象: 1、补丁安装失败,补丁服务卡在补丁安装的中间过程。
2、系统内大量僵尸进程堆积。
3、systemd 卡住,无法通过systemctl管理系统服务。
4、环境中存在多个login的coredump文件。
5、reboot命令失效,无法通过软件重启修复环境,需要通过BMC重置CPU。
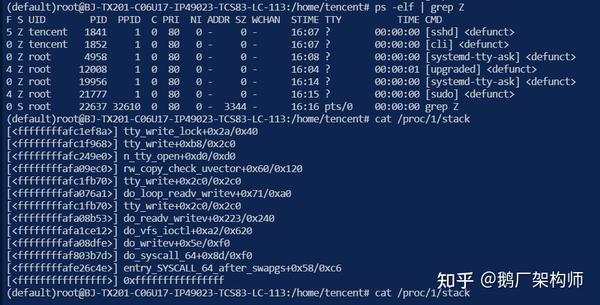
故障场景下的进程状态如下图:
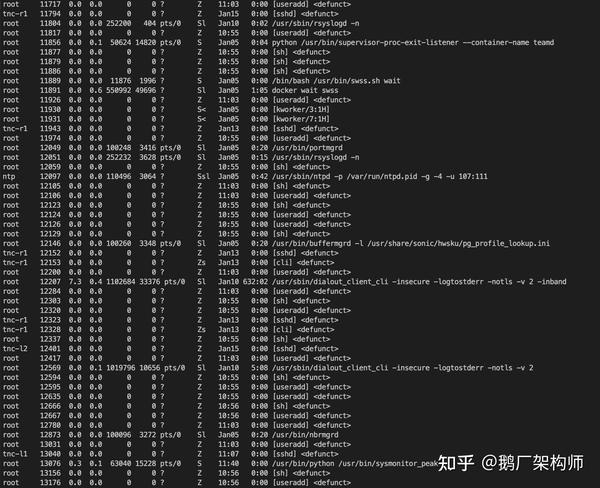
案例2: upgraded 处理 process-exporter 时出异常导致 redis 消息积压、存储空间满,出 portsyncd 异常退出告警,定位时 upgraded 服务无法停止、后台很多僵尸进程
故障现象:
1、redis消息积压,磁盘空间耗尽,关键业务进程退出。
2、系统后台大量僵尸进程
3、systemd卡住,无法通过systemctl管理服务
这两例有相似的过程,系统中都有大量僵尸进程,systemd的内核栈调用栈也相似。
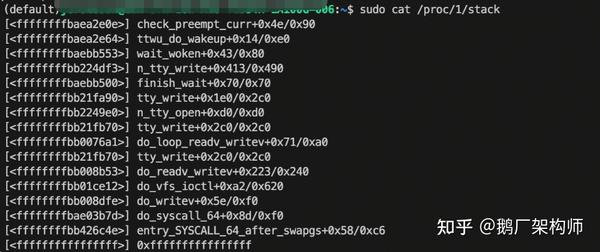
这些案例的最大影响在于,问题在补丁部署过程中被发现,具体表现为补丁可能导致systemd崩溃。此时,运营团队需要决定是否暂停补丁部署;然而,暂停部署可能会降低现网设备的整体可用性。
因此,我们必须深入分析问题的根本原因,提供充分的理由来判断是否应暂停补丁部署,并找到有效的规避方案。
【问题分析】
什么是僵尸进程?问题环境为什么那么多僵尸进程?
在Linux系统中,进程间有明确的父子层级关系。通常情况下,当子进程退出(“挂了”)后,需要由父进程负责“收尸”,即通过wait()等调用回收子进程的系统资源,主要是回收进程号。
如果子进程运气不好,父进程先挂了,就会成为孤儿进程(Orphan Process),孤儿进程会自动托管给“systemd”进程。所以系统中总有一个进程负责“收尸”,systemd进程作为“收尸队长”稳定性至关重用。
死后没被"收尸"的进程就是僵尸进程(Zombie Process),这是官方称谓,需要认真对待。僵尸进程占用进程号资源,如果数量多了造成系统无法fork新进程。
系统中僵尸遍野,可以推测systemd进程罢工了,没人“收尸”,导致了僵尸进程堆积。
# cat /proc/1/status
 Name:   systemd
 Umask:  0000
 State:  S (sleeping)
...
 Cpus_allowed:   77
 Cpus_allowed_list:      0-2,4-6
 Mems_allowed:   00000000,00000001
 Mems_allowed_list:      0
 voluntary_ctxt_switches:        27166670
 nonvoluntary_ctxt_switches:     4515113
通过现网环境中,多次收集systemd的状态,主动任务上下文切换(voluntary_ctxt_switches)和被动上下文切换(nonvoluntary_ctxt_switches)次数不变化,可以确认systemd进程卡住。
systemd为什么卡住?
systemd进程是Linux系统的核心组件,他提供了更快的启动时间和更好的服务管理,替换了传统的Init进程,管理系统初始化、重启、服务、会话等。它是系统中所有进程的父进程,类似开天辟地的盘古。它卡住了,系统的天就塌了,僵尸进程横行,服务启停失效。
这么重要的进程,卡在哪儿了?
#cat /proc/1/wchan
tty_write_lock
通过查看 /proc/1/wchan 文件,可以确定 systemd 进程的阻塞点。wchan 是 "wait channel" 的缩写,用于标识进程正在等待的资源。这个术语源自 Unix 时代,至今仍在使用。当读取 /proc/1/wchan 文件时,内核会扫描 systemd 进程的内核栈,获取栈顶指针和相关寄存器的值,并将这些信息转译为内核符号,使我们能够轻松理解进程的等待状态。/proc路径是用户态和内核通信的重要通道,下文提到/proc路径下的内容,都是内核实时的内存内容,而非静态的文件。
那么,systemd 卡住时的上下文是什么样的呢?
#cat /proc/1/stack
[<ffffffffaa61ef8a>] tty_write_lock+0x2a/0x40
[<ffffffffaa61f968>] tty_write+0xb8/0x2c0
[<ffffffffaa6249e0>] n_tty_open+0xd0/0xd0
[<ffffffffaa409ec0>] rw_copy_check_uvector+0x60/0x120
[<ffffffffaa61fb70>] tty_write+0x2c0/0x2c0
[<ffffffffaa4076a1>] do_loop_readv_writev+0x71/0xa0
[<ffffffffaa61fb70>] tty_write+0x2c0/0x2c0
[<ffffffffaa408b53>] do_readv_writev+0x223/0x240
[<ffffffffaa408dfe>] do_writev+0x5e/0xf0
[<ffffffffaa203b7d>] do_syscall_64+0x8d/0xf0
[<ffffffffaa826c4e>] entry_SYSCALL_64_after_swapgs+0x58/0xc6
[<ffffffffffffffff>] 0xffffffffffffffff
/proc/1/stack可以查看systemd进程的内核栈,系统卡在了writev的系统调用中。systemd的实现非常复杂,调用writev的函数代码也很多,我怎么才能知道systemd用户态上下文?
# strace -p 1
strace: Process 1 attached
writev(23, [{iov_base="         ", iov_len=9}, {iov_base="Starting KLP(Kernel Live Patchin"..., iov_len=56}, {iov_base="\n", iov_len=1}], 3
strace可以跟踪系统调用,并且输出缓冲区内容。定位信息显示"Starting KLP(Kernel Live Patchin" 是KLP服务输出服务启动信息卡住了。systemd卡在了writev 操作fd=23的系统调用中,那么fd 23对应的是什么文件?
# ls -al /proc/1/fd
dr-x------ 2 root root  0 Apr 25 15:12 .
dr-xr-xr-x 9 root root  0 Jan 18 16:47 ..
lrwx------ 1 root root 64 Apr 25 15:12 0 -> /dev/null
lrwx------ 1 root root 64 Apr 25 15:12 1 -> /dev/null
...
l-wx------ 1 root root 64 Apr 25 15:12 23 -> /dev/console
可以看到fd23对应/dev/console,即systemd写入/dev/console时卡住了。那么谁在占用/dev/console?
# fuser /dev/console
/dev/console:
在fuser定位信息中,发现只有PID 1(即systemd)在占用/dev/console,也就是说没有其他进程争夺console。我们预期其他进程占用console,导致systemd卡console访问的假设不成立了,此时有些迷茫,暂时搁置这个线索。我们切换思路,使用pstree寻找可能导致systemd陷入这种上下文的用户态操作。
# pstree -a
systemd
  ├─agetty --noclear --keep-baud 115200 tty1 linux
  ...
  └─upgraded -u /usr/bin/upgraded
      └─sh -c sh /etc/sonic/patch/install.sh klp_manage
          └─sh /etc/sonic/patch/install.sh klp_manage
              └─usr_cmd.sh ./usr_cmd.sh -i
                  └─sudo systemctl start klp_manage.service
                      └─systemctl start klp_manage.service
通过上述信息,用户态角度看systemd卡住的过程已经明确了:
系统打补丁-》补丁服务(upgraded)操作klp_manage服务-》systemd输出“KLP”服务信息到控制台-》控制台(/dev/console)无法访问。
那么,systemd在特定场景下可能存在获取不到tty_write_lock信号量的bug?systemd进程在全球数以亿计的设备上运行,systemd社区并没有人反馈过类似的bug。因此,我们暂时排除了systemd本身存在bug的可能性,换个思路从console入手寻找突破口。
/dev/console是系统控制台的设备文件,我们需要查看console的配置。
# cat /proc/cmdline
BOOT_IMAGE=/image- XXX/boot/vmlinuz-4.9.0-8-amd64 root=/dev/sda3 rw console=tty0 console=ttyS0,115200n8 quiet ...
# cat /proc/consoles
ttyS0                -W- (EC p a)    4:64
tty0                 -WU (E  p  )    4:1
# cat /sys/devices/virtual/tty/tty0/active
tty1
可以确认console对应的是ttyS0和tty0两个设备。先梳理一下console和tty等概念:
终端(tty):从应用角度看,终端是提供标准输入(stdin)、标准输出(stdout)和标准错误(stderr)等I/O功能的进程或设备。终端包括虚拟终端(如ssh、telnet)和实体终端(如串口、屏幕键盘)。
控制台(console):从内核角度看,提供内核标准输出的设备,主要包括串口和屏幕键盘等实体终端。
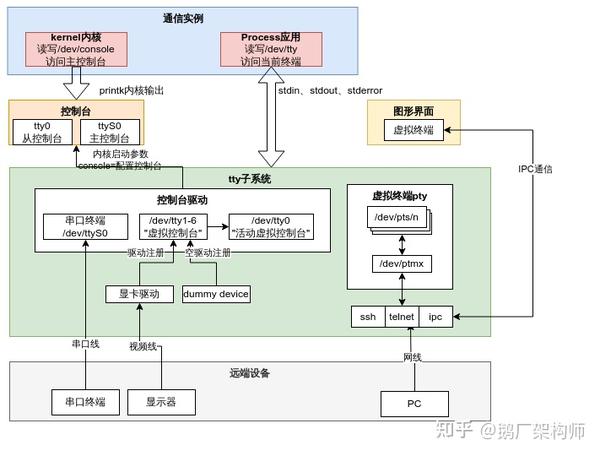
tty0是一个特殊的终端设备,它通常代表当前活动的虚拟控制台(virtual console)。通过内核信息(dmesg)确认tty0对应的真实设备。
#dmesg
[    0.000000] Console: colour dummy device 80x25
[    0.000000] console [tty0] enabled
[    0.000000] console [ttyS0] enabled
#cat /sys/class/tty/tty0/active
tty1
可以确认tty0真实设备为tty1。tty1为虚拟控制台,一般为显示器,但交换机设备上没有显卡硬件。结合console驱动源码分析。
static const char *dummycon_startup(void)
{
    return "dummy device";
}

const struct consw dummy_con = {
    .owner =		THIS_MODULE,
    .con_startup =    dummycon_startup,
    .con_init =		dummycon_init,
...
    .con_font_get =    DUMMY,
    .con_font_default =    DUMMY,
    .con_font_copy =    DUMMY,
};
static int __init con_init(void)
{
...
    if (conswitchp)
		display_desc = conswitchp->con_startup();
...
    pr_info("Console: %s %s %dx%d\n",
		vc->vc_can_do_color ? "colour" : "mono",
		display_desc, vc->vc_cols, vc->vc_rows);
    printable = 1;
}
“Console: colour dummy device 80x25”说明tty为"dummy device",即空操作设备。其行为类似/dev/null是个字符黑洞。所以console只能输出到ttyS0上,tty0是空操作不会引入异常排除掉。 综上得到如下推论: /dev/console是/dev/ttyS0的别名,如果ttyS0被卡住,/dev/console就会发生阻塞。
排查思路重新回到console抢占失败导致systemd卡住,通过fuser继续确认谁在占用ttyS0,以及占用进程的状态。
# fuser /dev/ttyS0
/dev/ttyS0:  11125
# ps -p 11125
  PID TTY          TIME CMD
11125 ttyS0    00:00:00 login
# cat /proc/11125/stack
[<ffffffffaa285ad7>] recalc_sigpending+0x17/0x50
[<ffffffffaa63f769>] uart_write_room+0x69/0xe0
[<ffffffffaa2bb553>] wait_woken+0x43/0x80
[<ffffffffaa624df3>] n_tty_write+0x413/0x490
[<ffffffffaa2bb500>] finish_wait+0x70/0x70
[<ffffffffaa61fa90>] tty_write+0x1e0/0x2c0
[<ffffffffaa6249e0>] n_tty_open+0xd0/0xd0
[<ffffffffaa408850>] vfs_write+0xb0/0x190
[<ffffffffaa409c92>] SyS_write+0x52/0xc0
[<ffffffffaa203b7d>] do_syscall_64+0x8d/0xf0
[<ffffffffaa826c4e>] entry_SYSCALL_64_after_swapgs+0x58/0xc6
[<ffffffffffffffff>] 0xffffffffffffffff
proc信息看到login进程已经通过tty_write_lock的信号量,但卡在串口写入缓冲区uart_write_room。
到达问题定位关键点,故障场景内核态的上下文已经确认:串口缓冲区满,login拿到串口信号量后卡在写入缓冲区上,systemd卡在拿不到串口信号量。
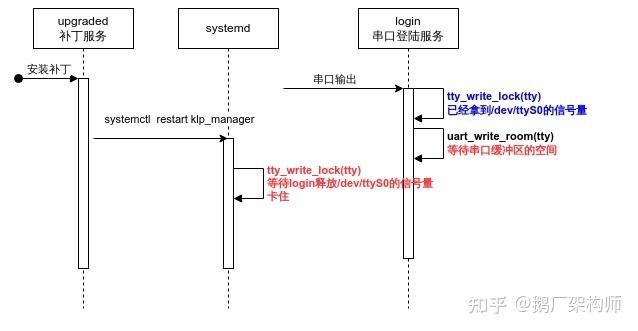
是否串口缓冲区满,就能看到和现网一样的故障现象?我们动手验证一下,首先搞清楚/dev/console到写入串口的逻辑,寻找构造缓冲区阻塞的条件。
通过下述命令行收集写入/dev/console时函数调用轨迹:
终端1# trace-cmd record -p function_graph -g SyS_write  ... #通过ftrace命令记录系统函数调用轨迹
终端2# echo xxx >/dev/console
终端1# ctrl+c 停止轨迹收集,trace-cmd report | grep echo #过滤获取echo线程的内核调用栈轨迹
最终收集到的调用轨迹如下:
SyS_write() {
  vfs_write() {
    __vfs_write() {
      redirected_tty_write() { //file->f_op->write=> console_fops.write=redirected_tty_write
        tty_write() {
          tty_paranoia_check();
          tty_ldisc_ref_wait()
          do_tty_write(){ //内联函数 ret = do_tty_write(ld->ops->write, tty, file, buf, count);
            tty_write_lock()
            __check_object_size()
            n_tty_write() {  //ld->ops->write => n_tty_ops.write=n_tty_write
              down_read()
              process_echoes();
              add_wait_queue()
              tty_hung_up_p();
              process_output() {//处理一个写出
                tty_write_room() {
                  uart_write_room() // tty->ops->write_room()==>struct tty_operations uart_ops.uart_write_room(tty)
                }
                do_output_char(){
                ...
              uart_flush_chars() { //tty->ops->flush_chars()
                uart_start() {
                  _raw_spin_lock_irqsave();
                  __uart_start.isra.11() {
                    serial8250_start_tx();
                    ...
可以看到,字符串输出到串口的逻辑:首先会tty_write_lock拿到tty信号量后,然会调用tty_write_room写入串口缓冲区,最终调用uart_flush_chars通过串口硬件发出。
只需要uart_flush_chars最终输出的位置拦截,理论上就能构造串口缓冲区满。使用livepatch技术,直接替换内核uart_flush_chars函数实现,使其变为阻塞的空操作。
static void uart_flush_chars(struct tty_struct *tty)
{
    while(1){
        ssleep(1);
    }
}
开始验证:
1、向内核注入livepatch补丁,修改uart_flush_chars的行为,insmod ./console_patch.ko 2、ssh终端1,执行echo xxx >/dev/console,使echo进程卡死的串口输出上 3、ssh终端2,执行systemctl restart upgraded,使systemd尝试想串口打印服务启停信息 4、ssh终端3,进入shell后,直接关掉weterm,尝试制造僵尸进程 经验证,制造故障的场景与现网故障完全一致 ,即systemd卡住的原因与串口高度相关。
问题的核心来到串口缓冲区为什么会满? 可能的原因包括串口硬件异常和驱动异常。然而,在一个月内发生了两起类似案例,而这些案例都涉及技术成熟的串口硬件,这种概率极低,因此硬件缺陷的定位思路被排除了。
接下来,我们从驱动方面寻找突破口。8250串口驱动是Linux内核自带的,社区中没有相关的缺陷报告,因此驱动缺陷的定位思路也被堵死了。
那么,是否可能是控制台自带的功能导致的呢?我们需要进一步查看串口配置。
# stty -F /dev/ttyS0

speed 115200 baud; line = 0;
-brkint ixoff -imaxbel iutf8
-iexten
震惊!内核很严谨的在ttyS0上支持了一个意外的功能--“ixoff”串口流控。 这个功能是在串口接收端缓冲区不足时,发送XOFF(ASCII 码0x13,是控制指令)触发发送端停止发送,避免数据丢失。
我本地使用中断发送XOFF命令,很容易触发了串口假死,缓冲区很快就满了。线上环境还有这种老六操作?
我相信运营同学不会无事生非,答案只能是无意的错误输入。继续寻找串口异常的蛛丝马迹。
# ls -lh /host/core
total 600K
-rw-rw-rw- 1 root root 120K May  x 20:10 login.1715170208.18505.core.gz
-rw-rw-rw- 1 root root 120K May  x 20:10 login.1715170223.24232.core.gz
-rw-rw-rw- 1 root root 120K May  x 20:12 login.1715170335.27246.core.gz
-rw-rw-rw- 1 root root 120K May  x 14:43 login.1715323385.17268.core.gz
-rw-rw-rw- 1 root root 120K May  x 14:43 login.1715323403.18457.core.gz
....
那么多login的coredump文件也很让人震惊,历史悠久login进程这么脆弱吗?随便找一个分析分析。
#gdb /bin/login login.**.core
Core was generated by `/bin/login --       '.
Program terminated with signal SIGQUIT, CPU time limit exceeded.
#0  0x00007fca15709910 in read () from /lib/x86_64-linux-gnu/libc.so.6
(gdb)
果然不是login本身逻辑的锅,而是因为收到SIGQUIT自动退出了。怎么就收到SIGQUIT信号呢?
在任意终端(串口、ssh、telnet)输入ctrl+\组合地区可以产生SIGQUT信号。问题是login进程只负责系统登陆认证,login进程是必须在输入用户名后,提示passwd敲密码时,敲ctrl+\才会转换为SIGQUIT信号,产生core文件。
在交换机系统上,ssh使用的事其他的用户登陆认证方式。只有在串口终端上,才会用到login作为用户登陆认证。关键推论:有人在现网设备上反复尝试登陆?
询问机房驻场人员,问题设备上连着串口线,但没有连串口服务器,没人使用过问题设备的串口。除了见鬼,能不能解释这种灵异行为?
终于到了答案揭晓的时刻:世界上没有鬼,在电磁信号复杂的环境中,悬空的串口线像天线一样,自动捕捉了周围的电磁波,感应到电平信号会被linux识别为有效输入。感应的错误字符是随机的,linux系统对字符输入进行处理,随机的字符串会有不同的动作:
- 如果遇到换行控制符,设备就会启动login进程;
- 如果遇到SIGQUIT信号,login就coredump;
- 如果遇到了XOFF停止发送指令,设备串口就假死了。这点也是最致命的。
假死的串口,经过一连串的错误积累,Linux系统崩溃,无法reboot了。至此,串口线悬空致linux崩溃之谜告破。
那么容易感应出乱码,是不是串口硬件设计缺陷?
在交换机和服务器硬件上常见的串口通信标准是 RS-232,它通过 RX(接收)、TX(发送)和 GND(地)三根线传递数据。
在交换机串口的RX信号量pin上增加了下拉电阻,尽量避免悬空信号的不确定性,串口通信要求RX、TX、GND必须接好,避免RX乱码的情况。
串口线悬空的影响包含: 1、TX数据信号耦合到RX,产生乱码。经硬件同事验证,串口线对端悬空的情况下,在串口TX输出时,TX的信号没有良好的地回路,导致能量从RX泄放(耦合),幅度可以达到1.5V以上满足芯片要求,导致串口RX接收到乱码。
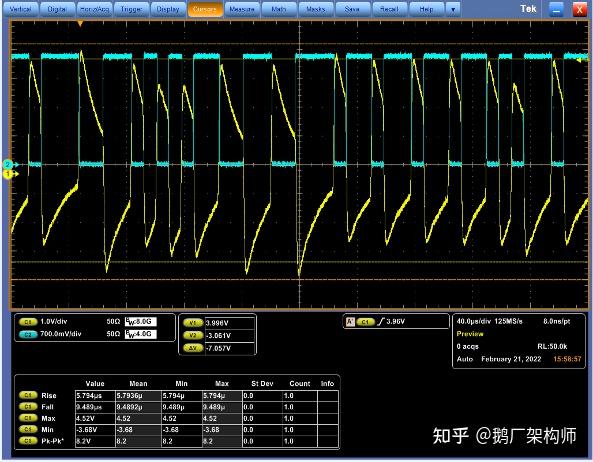
2、外部电磁环境复杂(跟电源线捆绑等),串口的RX线感应到电压产生乱码。
同时以“串口线悬空 ”作为关键字能搜索到很多接收数据异常的案例: 1、《Arduino 输入引脚悬空时,串口信号不稳定》https://blog.csdn.net/rocketeerLi/article/details/103509693
2、《CC2642R: cc2642的串口悬空接收数据异常》https://e2echina.ti.com/support/wireless-connectivity/bluetooth/f/bluetooth-forum/799064/cc2642r-cc2642
3、《systemd can get stuck if system console is broken》https://github.com/systemd/systemd/issues/29095
综上这并非硬件设计缺陷,而是因为生产环境串口线连线不合理导致的问题。
举一反三mgmt管理口的网线会不会存在类似乱码输入故障?
分情况讨论: 场景一、网线悬空。悬空的网线会感应出信号,但通常不会发导致网口up、down震荡,或收到错包等现象。原因是,网络接口卡(NIC)通常会检测物理链路的完整性,如使用载波侦听多路访问/碰撞检测(CSMA/CD)等机制。如果没有检测到载波信号,NIC 会认为链路是断开的,并不会尝试解码任何数据。
场景二、网线质量不过关。网线质量不过关,往往会导致乱码(即错包)。链路层有CRC校验,TCP层有重传等机制,避免乱码带来的影响。此时通过ifconfig等工具,能够检测这种错包情况,来评估是否更换网线。
综上,mgmt管理口网线一般不会因为乱码输入引入故障。
reboot命令为什么失效? reboot过程是启动过程的逆过程。设备启动过程,服务启动顺序是systemd控制的,设备reboot过程,服务停止顺序,同样依赖systemd控制。通过下面命令我们可以看到reboot命令实际上是systemctl的软连接。
# ls -lh /sbin/reboot
lrwxrwxrwx 1 root root 14 Jun 29  2022 /sbin/reboot -> /bin/systemctl
systemd进程卡住后,reboot命令自然会失效。最终造成了我们的故障环境不能通过reboot恢复。
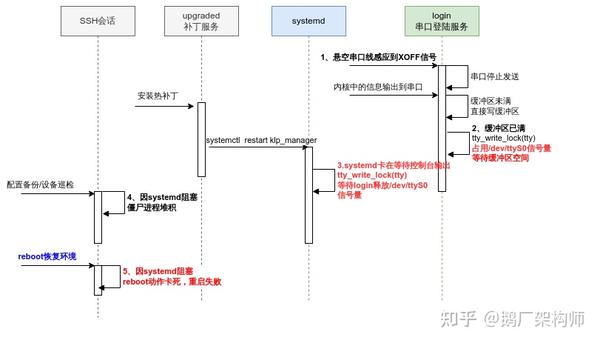
总结:问题的触发过程
1、串口线悬空,在复杂电磁环境上感应到电平,形成乱码输入。乱码命中XOFF(停止发送串口流控命令),串口停止发送字符。
2、写入控制台的信息都会写入缓冲区,缓冲区充满后,最后一个写入控制台的进程会占用串口信号量,并阻塞在等待缓冲区上。
3、热补丁(或其他操作触发了systemctl restart操作)安装,systemd向控制台输出信息,systemd卡在等待控制台输出上。
4、设备配置备份和巡检频繁与设备连接断开,形成僵尸进程,systemd阻塞无法回收僵尸进程资源。
5、最终,僵尸进程堆积,服务异常且无法正常通过reboot恢复环境。
【问题复现】
1、串口终端,敲入任意字符如“root”,提示passwd:,此时使用ssh终端发送ascii码\x13,即串口流控指令-停止发送xoff
2、ssh终端1,执行下述脚本,使得串口缓冲区满while true; do echo "0123456789012345678901234567890123456789012345678901234567890123456789012345678901234567890123456789012345678901234567890123456789" > /dev/console; sleep 0.1; done
3、ssh终端2,执行下述脚本,使得systemd卡住ystemctl restart upgraded
在串口收到xon恢复报文发送之前,systemd会持续卡住
这个过程复现的现象(systemd与login的调用栈),与现网完全一致。