30分钟搞定AES系列
七月 18, 2025 [网络与安全] #obsidian #合集 #密码学30分钟搞定AES系列(上):基础特性-腾讯云开发者社区-腾讯云
什么是AES
AES是对称加密算法的一种,全称是ADVANCED ENCRYPTION STANDARD。
高级加密标准 (AES) 指定了 FIPS 批准的 可用于保护电子数据的密码算法。AES 算法是一种对称分组密码,可以对信息进行加密(加密)和解密(解密)。加密将数据转换为难以理解的形式,称为密文;解密密文会将数据转换回其原始形式,称为明文。
关于AES标准的详细论述,可以参考《Federal Information Processing Standards Publication 197》,这里不再赘述。
AES支持的模式
AES支持以下加密模式:
1. ECB模式(The Electronic Codebook Mode)
2. CBC模式(The Cipher Block Chaining Mode)
3. CTR模式(The Counter Mode)
4. GCM模式(The Galois/Counter Mode)
5. CFB模式(The Cipher Feedback Mode)
6. OFB模式(The Output Feedback Mode)
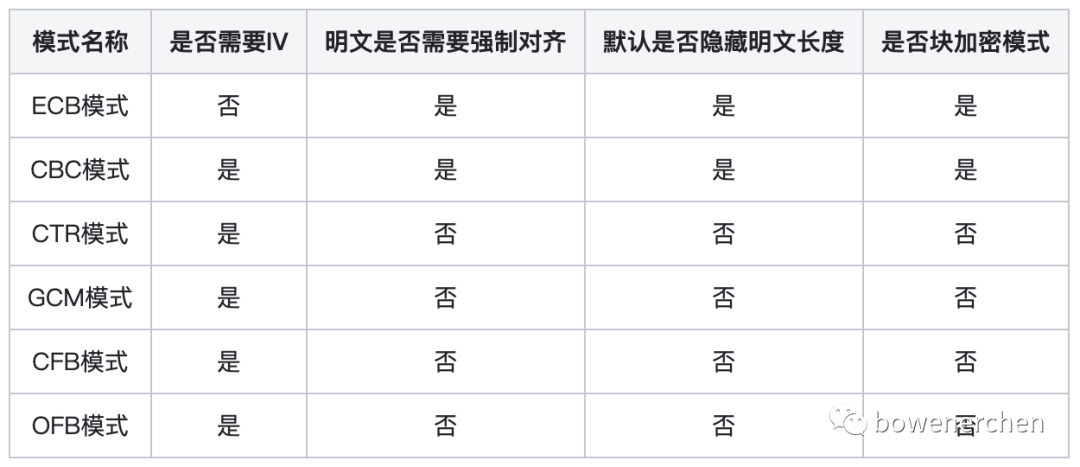
AES的加密模式根据加密方式的不同,简单分为块加密模式与流加密模式两种。
块加密模式最为常见同时在工程化中使用最为普遍的是CBC模式。
流加密模式最具代表性的是GCM模式。
块加密与数据填充
明文数据的填充是块加密模式最重要的特点之一。
为什么需要填充呢?这有个很重要的原因是因为,加密库(或者说加密算法)本身,是无法预料用户输入的明文长度究竟是多少的!
对于AES来说,ta只知道自己是按照16字节进行分组加密的,这里的分组加密说的更严谨点,应该是,对明文按照16个字节进行分组进行加密(这里我们暂时不讨论每种模式下的区别)。
如果输入的明文长度不是16字节整数倍,这个时候就需要强行将明文进行填充对齐,使其能够满足分组规则。
比较常见的几种填充法则如下:
- NoPadding:顾名思义,就是不填充。缺点就是只能加密长为BlockSize倍数的信息,一般不会使用。
- ZerosPadding:全部填充0x00,无论缺多少全部填充0x00,已经是BlockSize的倍数仍要填充,一般工程上不使用这种方式。
- PKCS#5:缺几个字节就填几个字节,每个字节的值为缺的字节数;在AES加密当中严格来说是不能使用PKCS#5的,因为AES的块大小是16bytes而PKCS#5只能用于8bytes。
- PKCS#7:缺几个字节就填几个字节,每个字节的值为缺的字节数;当长度不对齐时,将数据填充到满足分组的长度;当长度刚好对齐时,在原始数据末尾新增一个填充块;OpenSSL在AES加密中默认使用PKCS#7。
- ISO 10126:最后一个字节的值是需要填充的字节数(需要填充的字节数包括了最后一字节),其他全部填随机数。
- ANSI X9.23:跟ISO 10126很像,只不过ANSI X9.23其他字节填的都是0而不是随机数。
PKCS#7填充效果:
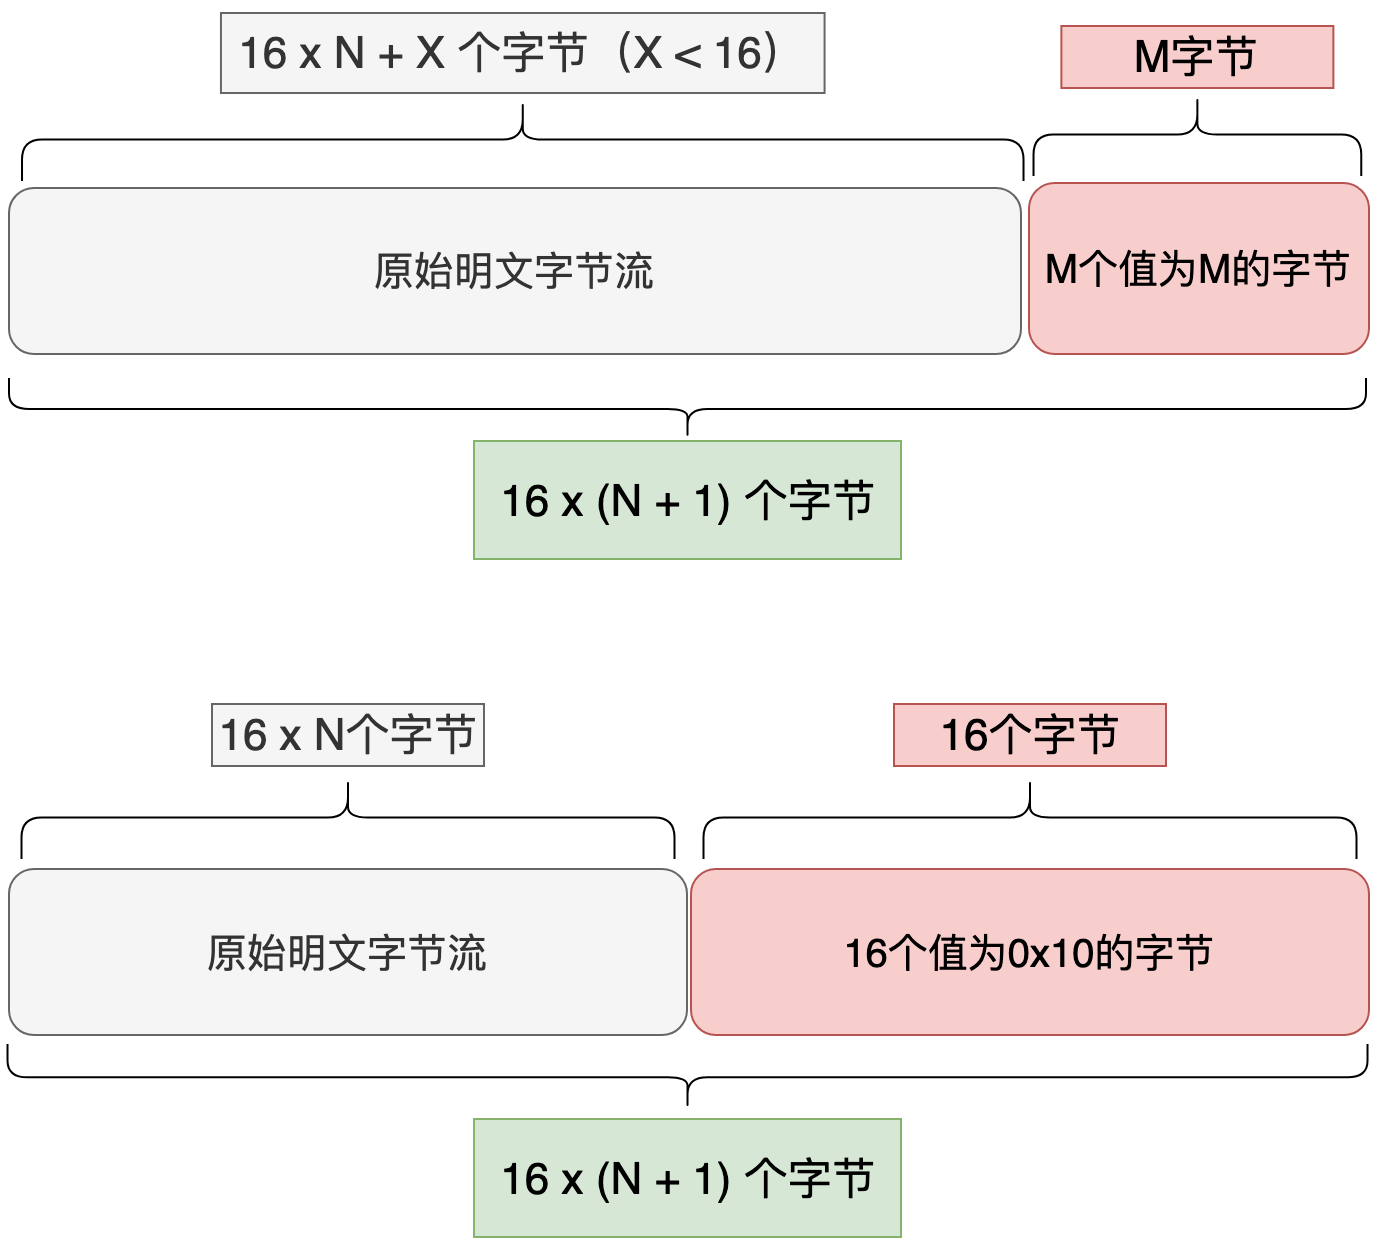
image.png
    def padding_check(self, origin: str, block_size: int):
        """
            假设BlockSize为128即16个字节,则:
            对于原文长度不足16个字节的,按照16字节(128比特)的BlockSize进行填充
        """
        padder = padding.PKCS7(block_size).padder()
        ret = padder.update(origin.encode('utf-8'))
        ret += padder.finalize()
        print("origin=", list(origin),
              "after padding=", list(ret))

        """ 验证填充完成后的字节数是否符合预期 """
        self.assertEqual(len(ret) % get_bytes_len(block_size), 0)

        """ 填充值同时也是填充的字节长度 """
        padding_value = get_padding_value(
            get_bytes_len(block_size), len(origin))

        """ 填充长度为 padding_value 个字节,每个字节的值应该都是 padding_value """
        for i in range(1, padding_value + 1):
            self.assertEqual(int(ret[0 - i]), int(padding_value))
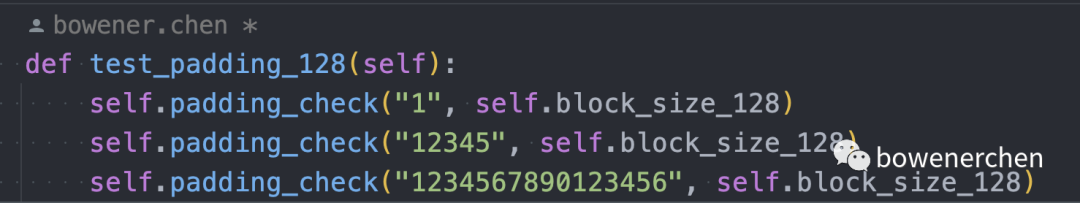
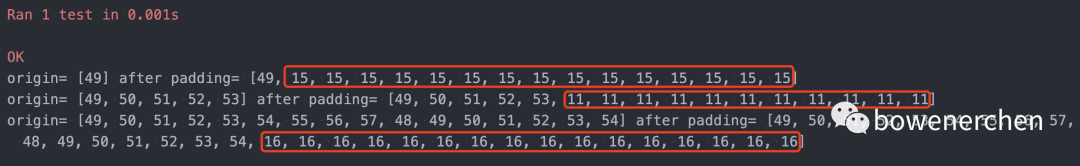
本文后续内容我们默认使用PKCS#7进行冗余填充。
不安全的块加密:ECB
ECB模式是不安全的,不建议在工程实践中使用这种模式。
    def test_ecb_cipher(self):
        origin_1 = "aaaaaaaaaaaaaaaa"
        origin_2 = "bbbbbbbbbbbbbbbb"
        origin_3 = (origin_1 + origin_2)
        key = "1234567890123456".encode('utf-8')
        aes_obj = aes_encryption.aes_encryption("ecb", key)
        print("Current AES Mode:", aes_obj.current_mode)
        cipher_1, cipher_1_len = aes_obj.encrypt(origin_1.encode('utf-8'))
        cipher_2, cipher_2_len = aes_obj.encrypt(origin_2.encode('utf-8'))
        cipher_3, cipher_3_len = aes_obj.encrypt(origin_3.encode('utf-8'))
        print("cipher_1:{}".format(list(cipher_1)))
        print("cipher_2:{}".format(list(cipher_2)))
        print("cipher_3:{}".format(list(cipher_3)))
        """ ECB模式下的密文与明文一一对应,不安全 """
        self.assertEqual(cipher_1_len % 16, 0)
        self.assertEqual(cipher_2_len % 16, 0)
        self.assertEqual(cipher_3_len % 16, 0)
        self.assertEqual(
            cipher_1[:cipher_1_len - 16] + cipher_2[:cipher_2_len - 16], cipher_3[:cipher_3_len - 16])
        self.assertEqual(len(aes_obj.key_value) % 16, 0)
        self.assertLessEqual(len(aes_obj.key_value), 32)
当我们使用ECB模式分别对明文:aaaaaaaaaaaaaaaa、bbbbbbbbbbbbbbbb以及aaaaaaaaaaaaaaaabbbbbbbbbbbbbbbb做加密时,我们稍微观察就会发现,密文其实是重复出现的。
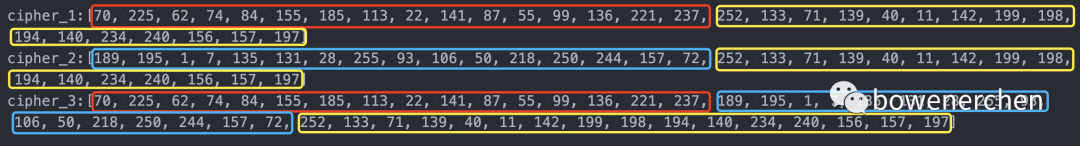
ECB模式有一个显著的安全问题:如果使用相同的密钥,那么相同的明文块就会生成相同的密文块,不能很好的隐藏数据模式。
细心点的朋友可能已经发现,重复出现的数据是三部分,那么为什么是三部分呢?
这个作为思考题留给大家,欢迎在评论区交流。
经典块加密模式:CBC
对于块加密模式来说,始终都有:密文长度与填充后的明文长度等长!!!
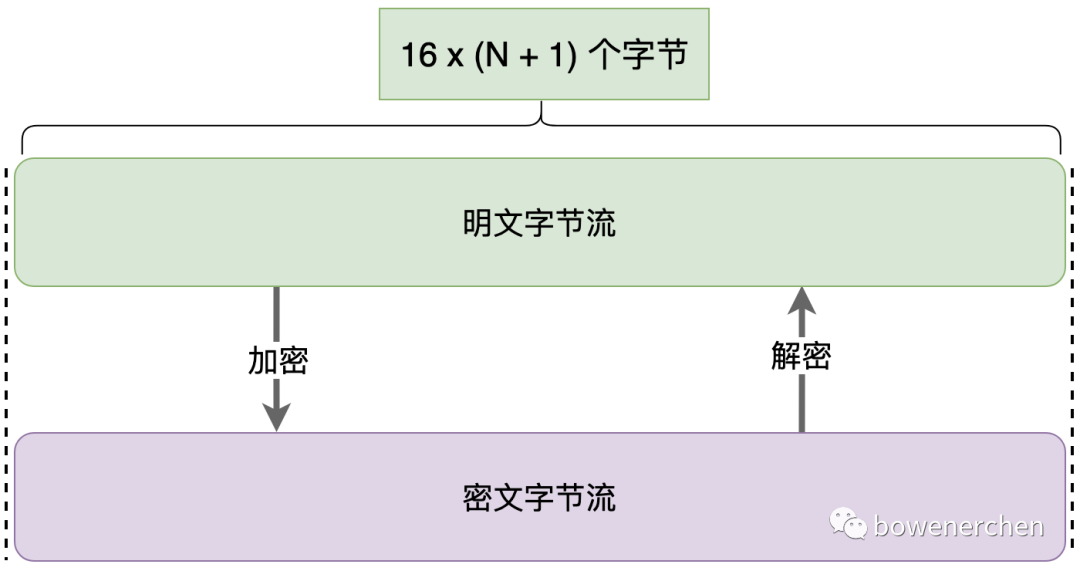
    def test_aes_cbc_encryption(self):
        origin = os.urandom(random.randint(17, 256))
        key = os.urandom(32)
        iv = os.urandom(16)
        aes_obj = aes_encryption.aes_encryption("cbc", key, iv)
        print("Current AES Mode:", aes_obj.current_mode)
        cipher, cipher_len = aes_obj.encrypt(origin)
        plain, plain_len = aes_obj.decrypt(cipher)
        self.assertEqual(plain, origin)
        self.assertEqual(len(origin), plain_len)
        self.assertGreaterEqual(cipher_len, len(origin))
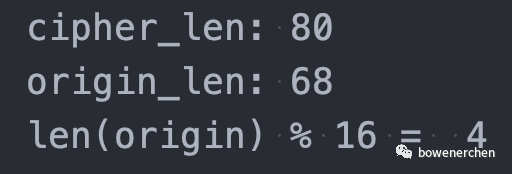
        print("cipher_len:", cipher_len)
        print("origin_len:", len(origin))
        print("len(origin) % 16 = ", len(origin) % 16)
        """
            假如原始数据长度等于 BlockSize * n,
            则使用 NoPadding 时加密后数据长度等于 BlockSize * n,其它情况下加密数据长度等于 BlockSize * (n+1)。
            假如原始数据长度等于 BlockSize*n+m [其中 m 小于BlockSize],
            除了 NoPadding 填充之外的任何方式,加密数据长度都等于 BlockSize*(n+1);
        """
        if len(origin) % 16 == 0:
            self.assertEqual(cipher_len, len(origin))
        else:
            self.assertEqual(cipher_len, (len(origin) // 16 + 1) * 16)
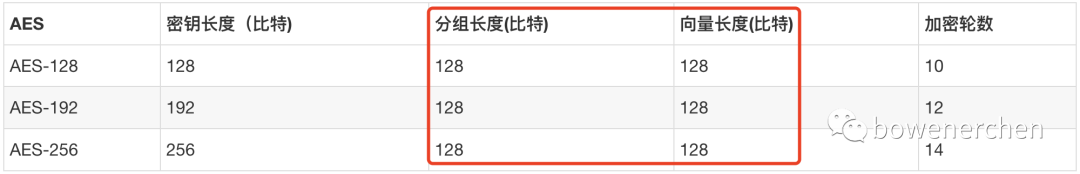
CBC模式作为工程上使用最广泛的一种加密模式,平时在使用它时,我们的密钥长度、IV长度、分组长度与加密轮转次数的关系如下图:
在 CBC 模式加密中,第一个输入块是通过将明文的第一个块与 IV 异或形成的。
前向密码函数应用于第一个输入块,并且结果输出块是密文的第一个块。该输出块还与第二个明文数据块异或以产生第二个输入块,并应用前向密码函数以产生第二个输出块。
该输出块,即第二个密文块,与下一个明文块异或以形成下一个输入块。每个连续的明文块与前一个输出/密文块进行异或运算以产生新的输入块。
前向密码函数应用于每个输入块以产生密文块。
在 CBC 解密中,逆密码函数应用于第一个密文块,得到的输出块与初始化向量进行异或以恢复第一个明文块。
逆密码函数也应用于第二个密文块,得到的输出块与第一个密文块异或以恢复第二个明文块。
经典的AES-CBC逻辑抽象图:
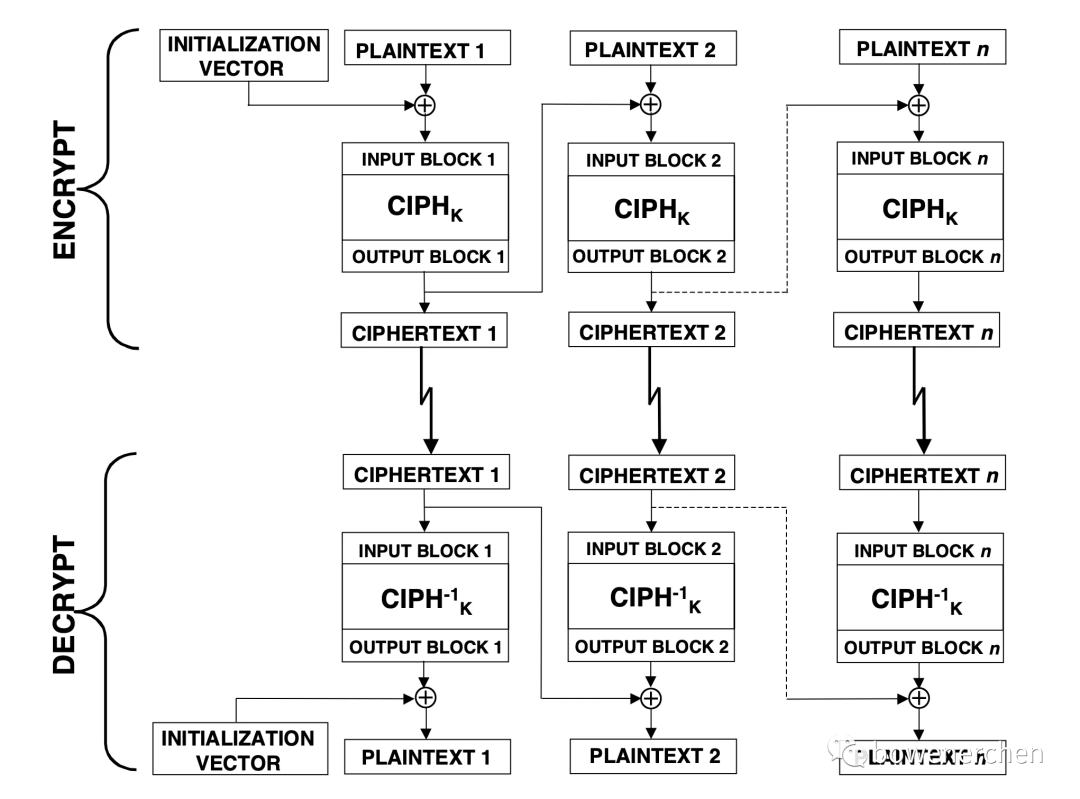
通常,要恢复任何明文块(第一个除外),将逆密码函数应用于相应的密文块,并将结果块与前一个密文块进行异或运算。
在 CBC 加密中,每个前向密码操作(第一个除外)的输入块取决于前一个前向密码操作的结果,因此前向密码操作不能并行执行。
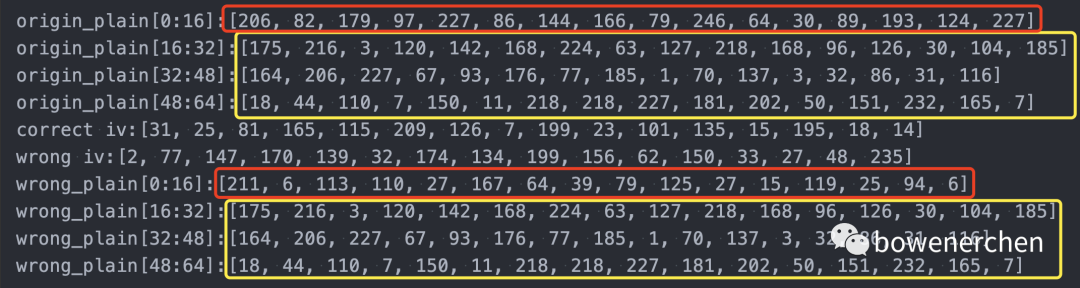
CBC模式的链式反应指的是加密的过程,因为当IV改变,加密过程中的所有密文block都会改变;
而解密的时候,IV只会对第一个明文block有影响。
    def test_aes_cbc_decrypt_by_wrong_iv(self):
        """
            CBC模式的链式反应一般指的是加密的过程,因为当IV改变,加密过程中的所有密文block都会改变
            而解密的时候IV只会对第一个明文block有影响
        """
        # 64字节长度的明文
        origin_plain = os.urandom(64)
        print("origin_plain[0:16]:{}".format(list(origin_plain[0:16])))
        print("origin_plain[16:32]:{}".format(list(origin_plain[16:32])))
        print("origin_plain[32:48]:{}".format(list(origin_plain[32:48])))
        print("origin_plain[48:64]:{}".format(list(origin_plain[48:64])))
        # 32字节长度的key
        key = os.urandom(32)
        # print("key:{}".format(list(key)))
        # 16字节长度的iv
        iv = os.urandom(16)
        print("correct iv:{}".format(list(iv)))
        aes_obj = aes_encryption.aes_encryption("cbc", key, iv)
        cipher, cipher_len = aes_obj.encrypt(origin_plain)
        # 使用正确的key 和 iv进行解密
        plain, plain_len = aes_obj.decrypt(cipher)
        self.assertEqual(plain, origin_plain)
        self.assertEqual(len(origin_plain), plain_len)
        self.assertGreaterEqual(cipher_len, len(origin_plain))
        # 将iv设置为错误的值
        aes_obj.iv_value = os.urandom(16)
        self.assertNotEqual(iv, aes_obj.iv_value)
        print("wrong iv:{}".format(list(aes_obj.iv_value)))
        wrong_plain, wrong_plain_len = aes_obj.decrypt(cipher)
        print("wrong_plain[0:16]:{}".format(list(wrong_plain[0:16])))
        print("wrong_plain[16:32]:{}".format(list(wrong_plain[16:32])))
        print("wrong_plain[32:48]:{}".format(list(wrong_plain[32:48])))
        print("wrong_plain[48:64]:{}".format(list(wrong_plain[48:64])))
        # 即使使用错误的iv进行解密,但是得到的长度还是正确的,只是解密出来的内容会有不同
        self.assertNotEqual(wrong_plain, origin_plain)
        self.assertNotEqual(wrong_plain, plain)
        self.assertEqual(len(origin_plain), wrong_plain_len)
        # 解密的时候,错误的iv只影响明文块的第一个16字节block
        self.assertNotEqual(wrong_plain[0:16], origin_plain[0:16])
        self.assertEqual(wrong_plain[16:], origin_plain[16:])
CTR模式
在 CTR 加密中,在每个计数器块上调用前向密码函数,结果输出块与相应的明文块异或以产生密文块。对于最后一个块,它可能是u位的部分块,最后一个输出块的最高有效u位用于异或运算;最后一个输出块的剩余 b-u 位被丢弃。
在 CTR 解密中,对每个计数器块调用前向密码函数,将得到的输出块与相应的密文块异或以恢复明文块。对于最后一个块,它可能是u位的部分块,最后一个输出块的最高有效u位用于异或运算;最后一个输出块的剩余 b-u 位被丢弃。
在CTR加密和CTR解密中,前向密码功能可以并行执行;类似地,如果可以确定对应的计数器块,则可以独立于其他明文块恢复对应于任何特定密文块的明文块。此外,可以在明文或密文数据可用之前将前向密码函数应用于计数器。
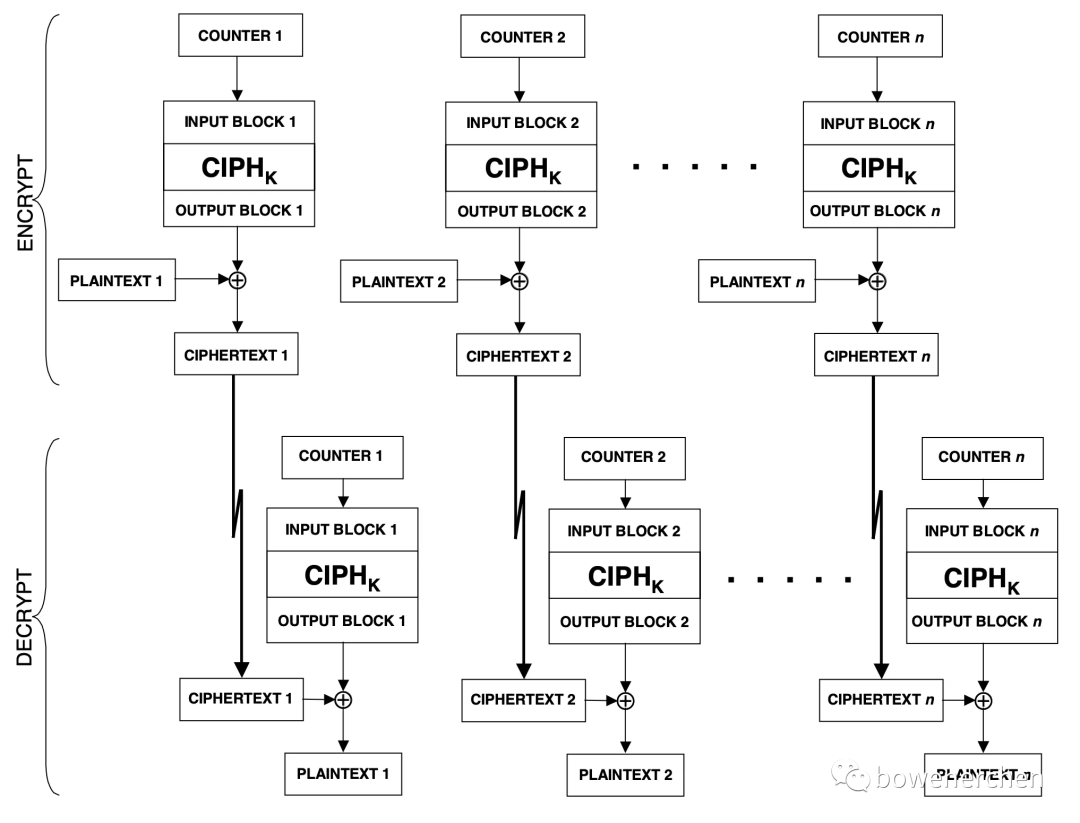
CTR模式有很多优点:易于理解,效率高,不需要padding,支持并行化,随机访问,以及只需要加密函数等等。
但是,CTR也有一些显而易见的缺点:
无法保证消息的完整性:
    缺乏消息身份验证,攻击者很容易对截获的加密消息进行比特翻转,再重放,且无需对其进行解密。
    而因为CTR模式的延展性,一个比特的反转就会带来毁灭性的结果。
计数器块重用导致明文泄露:
    如果计数器块(nonce)被重用,它可能会导致泄漏明文;
    特别是CTR模式加密需要唯一的随机数输入,绝对不能将其重复用于使用同一密钥加密的两条不同的消息,所以随机数生成方法尤为重要。
密文长度已知(可以通过padding对原文的长度进行隐藏):
    因为CTR模式不需要padding,所以其加密后的密文长度是可以知道的。
    尽管在许多加密方法中,消息长度并不被视作秘密(secert),但由于对称加密的特性,所以可以获得对应的明文长度,
    从而出现明文高位泄露的风险。
GCM模式
GCM可以提供对消息的加密和完整性校验,另外,它还可以提供附加消息的完整性校验。在实际应用场景中,有些信息是我们不需要保密,但信息的接收者需要确认它的真实性的,例如源IP,源端口,目的IP,IV,等等。
因此,我们可以将这一部分作为附加消息加入到MAC值的计算当中。
GCM模式是一种很经典的AEAD(Authenticated Encryption with Associated Data)。
AEAD是一种同时具备保密性,完整性和可认证性的加密形式。
AEAD 产生的原因很简单,单纯的对称加密算法,其解密步骤是无法确认密钥是否正确的,也就是说,加密后的数据可以用任何密钥执行解密运算,得到一组疑似原始数据,而不知道密钥是否是正确的,也不知道解密出来的原始数据是否正确,因此,需要在单纯的加密算法之上,加上一层验证手段,来确认解密步骤是否正确。
常见的 AEAD 算法有:
AES-128-GCM
AES-192-GCM
AES-256-GCM
ChaCha20-IETF-Poly1305
ChaCha20-IETF-Poly1305
具备 AES 加速的 CPU(桌面,服务器)上,建议使用 AES-XXX-GCM 系列,移动设备建议使用 ChaCha20-IETF-Poly1305 系列。
CBC与GCM的对比
AES-GCM可以并行加密解密,AES-CBC的模式决定了它只能串行地进行加密。
因为加密是耗时较久的步骤,且加密的方式是相同的,所以并行地实现AES-GCM算法的时候,其效率是高于AES-CBC的。
AES-GCM提供了GMAC信息校验码,用以校验密文的完整性。AES-CBC没有,无法有效地校验密文的完整性;
AES-GCM是流加密的模式,不需要对明文进行填充。AES-CBC是块加密的模式,需要对明文进行填充(AES-GCM中进行AES加密的是counter,AES-CBC中进行AES加密的是明文块)。
由于AES-CBC中必须要用到padding,导致最后一个明文块与其他密文块不同,因此可能会受到padding Oracle attacks,从而可以直接通过初始向量IV和密码,即可得到明文。
这一部分会在本系列的其他文章中详细描述,敬请期待!
30分钟搞定AES系列(下):IV与加密语义安全性探究-腾讯云开发者社区-腾讯云
- 30分钟搞定AES系列(下):IV与加密语义安全性探究-腾讯云开发者社区-腾讯云
- https://cloud.tencent.com/developer/article/2171237
- AES加密中IV至关重要,不同模式表现各异。ECB模式不安全,CBC模式用固定IV有风险,随机IV更安全。GCM模式对重复IV敏感,随机IV能提升安全性。IV需保证唯一性,CBC模式还要求随机性,合理使用IV可增强加密效果。
- 2025-07-18 13:26
从一张简单的图片开始
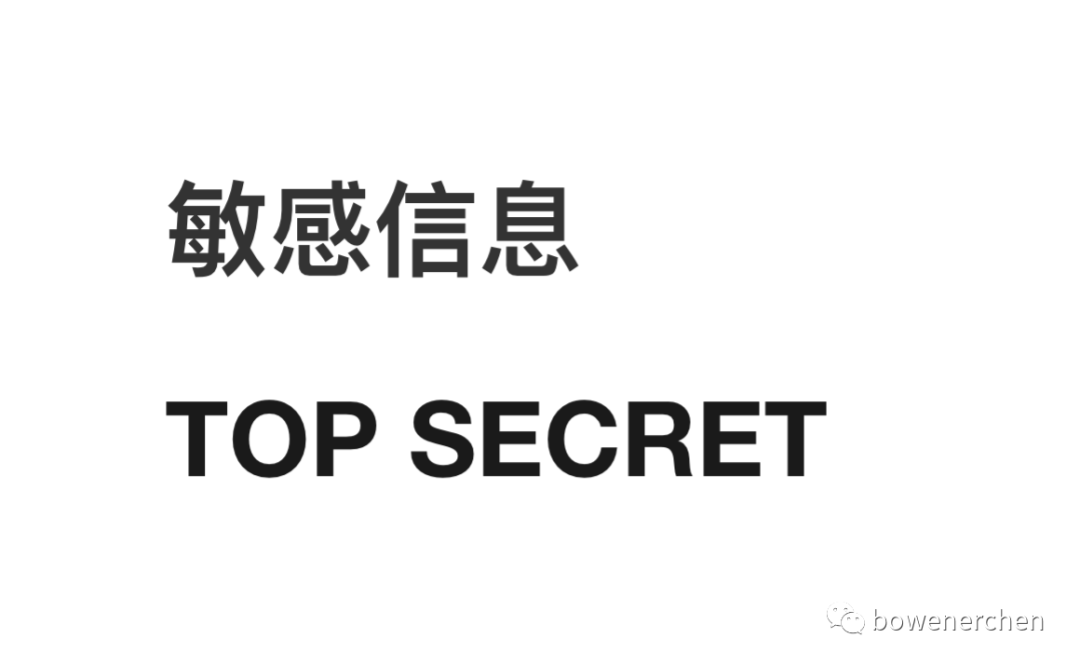
这是一张简单的图片,上面有一些文本内容:敏感信息 TOP SECRET
假设这张图片就是包含了高度敏感的信息,现在我需要隐藏其中的信息,我需要怎么做?
没错,我会用AES给他加密!
接下来,我们不妨尝试给它加密并看看效果。
再次强调:AES-ECB是不推荐的加密模式
在真正讨论IV对于加密效果的作用之前,不放我们先来论证下之前已经给出的一个结论:AES-ECB加密模式是不安全的,不推荐在工程中使用。
那么到底有多不安全呢?我们眼见为实!
我们约定使用的密钥key = b"test_png_encrypt",同时我们约定上图中需要被加密的文件为file = "top_secret.png"。
同时,为了更直观的验证加密效果并减少对图片加密细节的过分的阐述,我们这里约定:对于明文的png图片,按照行进行加密,用图片中的多行数据来模拟海量数据,用每行加密后的密文组合成的密文图片用于模拟各种加密模式在对海量**数据加密**后生成的密文的特征。
此时我们对文件做一次AES-ECB模式的加密:
    test_ecb = png_aes_encryption("ecb")
    test_ecb.key_value = key
    test_ecb.load(file)
    test_ecb.encrypt()
    test_ecb.save_cipher_png("cipher_ecb.png")
此时我们得到了如下效果的密文图片:
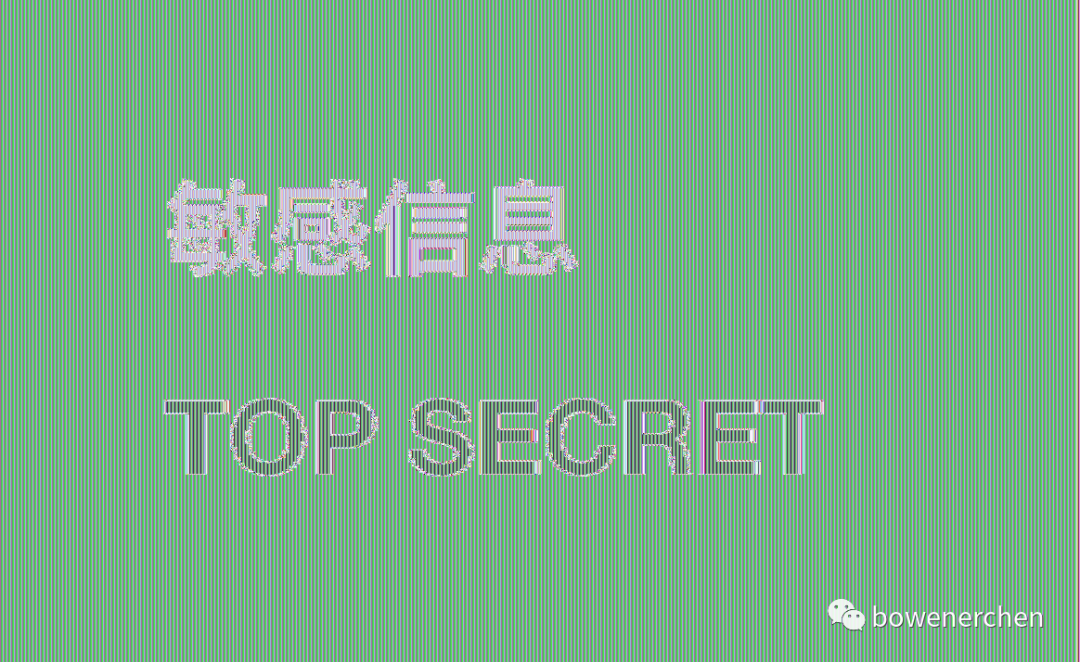
怎么形容这种感觉呢?
它看起来被加密了,但是加的并不多。
甚至,有种加了个寂寞的感觉!
AES-ECB是不需要使用IV的。 单纯依靠密钥本身进行分组加密,在给定的密钥下,任何给定的明文块总是被加密到相同的密文块。
这也是需要引入IV的原因。
IV使得加密过程变得更复杂,使明文的特征被更好的掩盖。
使用IV的AES-CBC模式就一定安全吗?
毫无疑问,CBC模式下引入IV后,至少可以推论出,它将不会如此完整的保留原始的明文信息。
但是,在实际工程中,仍然经常见到使用者为了省事,将同一份密钥与IV应用于海量的加密数据。
以这张图片来举例,假设整张图片代表的是海量的明文数据,那么在使用同样的密钥与IV对每一行数据加密后,我们可以得到如下的效果:
    test_cbc_fixed_iv = png_aes_encryption("cbc")
    test_cbc_fixed_iv.key_value = key
    test_cbc_fixed_iv.load(file)
    test_cbc_fixed_iv.iv_value = fixed_iv
    test_cbc_fixed_iv.encrypt(fixed_iv = True)
    test_cbc_fixed_iv.save_cipher_png("cipher_cbc_fixed_iv.png")
📄 [图片文字版] 密文随机性示意大图:竖直彩色条纹背景上有两条水平方向的纯噪点条带(右下角 bowenerchen 水印),整体如电视雪花——加密后的数据呈均匀随机分布,已看不出任何原图条纹或图案结构。
看起来效果似乎好了很多,已经完全无法看出来原始图片中的文字内容了。
但是,从统计学角度,当我们通过像素对比还是可以发现,密文图片中依旧保留了相当的原始图片的统计信息。
并且,通过肉眼来对比两张图片的噪声边缘,可以发现密文图片的噪声边缘几乎就是完美平滑的,与原文的文字部分几乎完美重合。
这说明,当对一个大文件(或被拆分为多个block的文件),在CBC模式下如果使用相同IV进行加密,则原始文件中的敏感信息特征可以被保留。
更准确一些来说,对于 CBC 模式,重复使用 IV 会导致:带有相同前缀的明文加密结果是相同前缀的密文。
假设两段明文长度各自是 128 字节和 160 字节,他们的前 33 字节相同。那么他们俩的密文,前 32 字节是相同的。
而如果我们在保持密钥key不变的前提下,每一行数据都是用不同的IV(这里每次都生成随机IV):
    test_cbc = png_aes_encryption("cbc")
    test_cbc.key_value = key
    test_cbc.load(file)
    test_cbc.encrypt()
    test_cbc.save_cipher_png("cipher_cbc.png")
则可以得到如下的效果:
📄 [图片文字版] 整幅为均匀随机噪点(电视雪花状,右下角 bowenerchen 水印),示意 AES 加密输出的密文与随机数据无异,肉眼无法从密文中分辨任何明文结构或图案。
当对每一行都是用随机IV时,整个图片的噪声分布看起来随机了很多,也就是说,从统计特征上来说,它保留的原始特征更少,肉眼可见的说明其安全性也是更好的。
必须强调:AES-GCM对于重复IV更加敏感
首先我们需要回顾下:GCM可以提供对消息的加密和完整性校验,是流式加密而非分组加密。
而流式加密的方式,其实对于重复IV是更敏感的。
    test_gcm_fixed_iv = png_aes_encryption("gcm")
    test_gcm_fixed_iv.key_value = key
    test_gcm_fixed_iv.load(file)
    test_gcm_fixed_iv.iv_value = fixed_iv
    test_gcm_fixed_iv.encrypt(fixed_iv = True)
    test_gcm_fixed_iv.save_cipher_png("cipher_gcm_fixed_iv.png")
在使用重复IV按行加密时,我们得到了如下效果的图片:
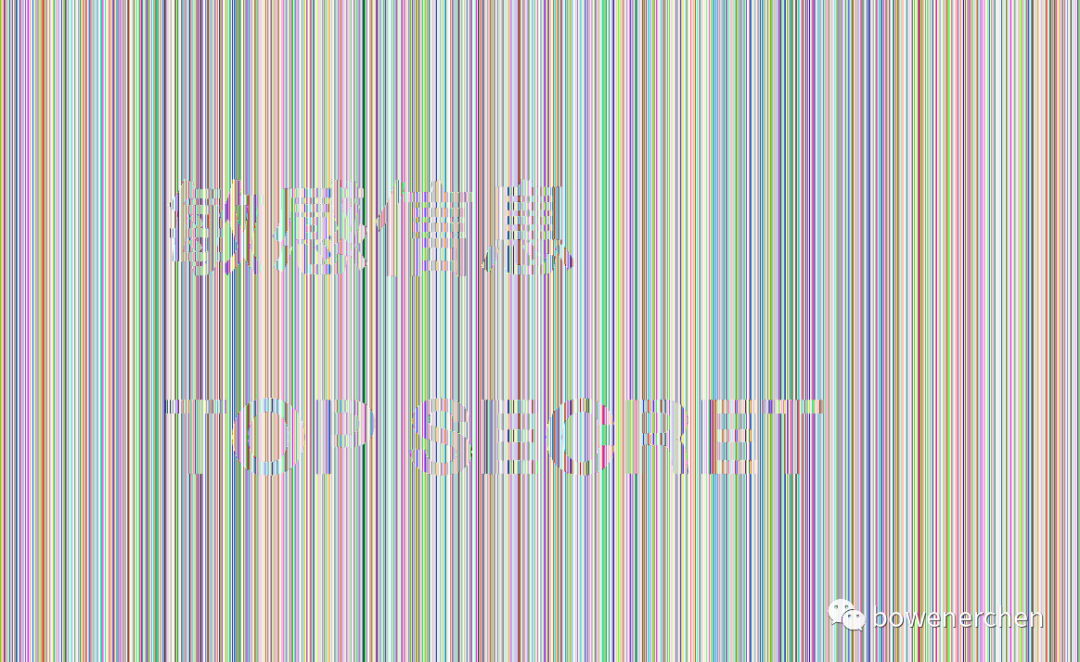
惊不惊喜?
意不意外?
如果固定IV的话,GCM模式的密文似乎跟ECB模式一样,对于原文的特征信息几乎完美保留,直接通过密文图片就可以看出来原始的文字信息。
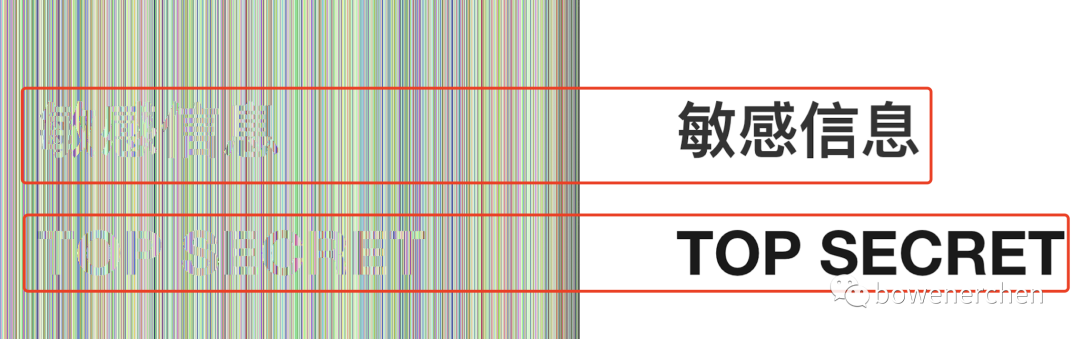
其实,对于 OFB/CTR/GCM 等分组密码转流密码的模式,重复使用 NONCE 会将其降级至 ECB 模式。
ECB 至少需要一个分组块(AES 是 16 字节)完全相同的明文才会得到相同的密文,而 OFB/CTR/GCM 只需要 1 个比特。如果两段明文的同一个位置的值是相同的,他们在密文的对应位置的值就是相同的;同时如果明文同位置的值相反,密文对应位置的值也相反。毕竟 1 比特只有 0, 1 两种取值。
那么,如果我们使用随机IV呢?
    test_gcm = png_aes_encryption("gcm")
    test_gcm.key_value = key
    test_gcm.load(file)
    test_gcm.encrypt()
    test_gcm.save_cipher_png("cipher_gcm.png")
(迁移注:原图片缺失
assets/1957a271e7c4a96f8b3c7fafa7bb43d9-20250718132247-ognngvv.png,已移除)
没错,在使用随机IV后,肉眼可见的感觉到了密文机密性更好了。
IV、密钥与机密性
IV,也就是初始化向量,其在加密算法中本身不需要保持秘密,它是可以被公开的。
Key,也就是密钥,在加密算法中是需要保持秘密的,它不可以被公开。
IV无论是对CBC模式还是对于GCM模式,对他都有一个最基本的要求:唯一性。
当IV只要求唯一性时,我们也可以叫它NONCE。
这里需要强调下:唯一性 与 随机性 是不一样的。
在GCM模式下,由于AES算子在内部会 计算ghash 把你输入的 IV(NONCE) 随机化一次,因此对于GCM模式来说,即使IV(NONCE)不是随机的也可以,也就是说,哪怕你使用GCM模式加密时输入的IV,每次都是在上一次IV的基础上加一,也是允许的,因此,在GCM模式下,一般我们不会使用IV的说法,而是直接叫NONCE,这个在常用的一些库中也可以体现:
apple的库:https://developer.apple.com/documentation/cryptokit/aes/gcm
一个很知名的C++库:https://doc.libsodium.org/secret-key_cryptography/aead/aes-256-gcm
go的库用法:https://gist.github.com/kkirsche/e28da6754c39d5e7ea10
而对于CBC模式来说,除了要求唯一性,还要求IV的随机性,什么叫随机性?
就是说,我根据当前的IV,无法猜测到下一个IV,如果根据当前的IV,我能猜测到下一个IV是把上一个IV的最后一个字节的值加一,那么它就失去了随机性。
通常来说,在工程应用上,我们保持IV的唯一性和随机性是最好的选择。
附录
部分关于png图片加密重写的代码片段,仅供参考:
def cut_list_with_step(lst: List[Any], step: int = 1):
    return [lst[i:i + step] for i in range(0, len(lst), step)]

class png_aes_encryption(object):
    def __init__(self, mode: str = "cbc"):
        self.__aes_operator = aes_encryption.aes_encryption(mode)
        self.__width: int = 0
        self.__height: int = 0
        self.__rows: List[bytes] = list()
        self.__info: Dict[str:Any] = dict()
        self.__cipher_rows: List[bytes] = list()

    @property
    def key_value(self) -> bytes:
        return self.__aes_operator.key_value

    @key_value.setter
    def key_value(self, key: bytes):
        self.__aes_operator.key_value = key

    @property
    def iv_value(self):
        return self.__aes_operator.iv_value

    @iv_value.setter
    def iv_value(self, iv: bytes):
        self.__aes_operator.iv_value = iv

    def load(self, filename: str):
        self.__width, self.__height, self.__rows, self.__info = png.Reader(filename = filename).read()
        print("file={filename}, file_info={info}".format(filename = filename, info = self.__info))

    def __generate_row_cipher(self, row_data: bytes) -> Tuple[bytes, int]:
        return self.__aes_operator.encrypt(row_data)

    def encrypt(self, block_size_in_bytes: int = 0, fixed_iv: bool = False):
        """
            block_size_in_bytes 默认为0, 表示按照矩阵的行进行加密
            否则将每行按照block_size_in_bytes进行拆分,然后对每个拆分的block进行加密
        """
        start = time.perf_counter()
        self.__cipher_rows = list()
        for i in self.__rows:

            if not fixed_iv:
                self.iv_value = bytes([random.randint(0, 255) for x in range(random.randint(8, 16))])

            if block_size_in_bytes <= 0:
                row_cipher, row_cipher_len = self.__aes_operator.encrypt(bytes(i))
                self.__cipher_rows.append(row_cipher)
            else:
                if block_size_in_bytes % 4 != 0:
                    raise ValueError("block_size_in_bytes has to be a multiple of 4 ")
                cut_row_cipher = bytes()
                cut_row_list = cut_list_with_step(bytes(i), block_size_in_bytes)
                for ci in cut_row_list:
                    tmp_cipher, tmp_cipher_len = self.__aes_operator.encrypt(bytes(ci))
                    cut_row_cipher += tmp_cipher
                self.__cipher_rows.append(cut_row_cipher)

        elapsed = round((time.perf_counter() - start), 3) * 1000
        print("mode={}, file_size={}, encryption time cost={}ms".format(self.__aes_operator.current_mode,
                                                                        self.__info["size"],
                                                                        elapsed))

    def save_cipher_png(self, filename: str):
        f = open(filename, 'wb')
        w = png.Writer(width = int(len(self.__cipher_rows[0]) / 4), height = len(self.__cipher_rows),
                       greyscale = self.__info['greyscale'],
                       alpha = self.__info['alpha'], bitdepth = self.__info['bitdepth'])
        print("try save png:filename={}, width={}, height={}".format(filename,
                                                                     int(len(self.__cipher_rows[0]) / 4),
                                                                     len(self.__cipher_rows)))
        w.write(f, self.__cipher_rows)
        f.close()