C++20中的CPO(定制点对象)与niebloid——ranges受约束算法的调用 - zclll's blog
三月 18, 2024 [C/C++] #C++ #obsidianC++20中的CPO(定制点对象)与niebloid——ranges受约束算法的调用 - zclll's blog
照例先来一个30s速览版本:
- CP(定制点)指的是对于一个特定名称、特定功能的函数调用可能需要派发给不同具体实现的调用点,此谓之“定制”;
- CPO(定制点对象)是用来解决定制点问题的一个工具;
- CPO的实现原理是:写成函数对象+
operator()的实现,根据规则,二阶段的ADL查找在一阶段名字查找发现对象实体的时候不发生; - niebloid是指
ranges算法的调用。它和CPO的关系是:niebloids现阶段使用CPO作为具体实现方式。
那么,正文开始:
CPO和niebloid应该说是C++20当中最为晦涩的概念了,对于大多数人来说,我们永远都不需要自己去实现这种东西。但它们当中蕴含的技巧非常之巧妙,能够让我们对函数调用和库功能设计的理解提高一个档次。
1 Intro
大多数讲解CPO的文章都会提到swap的例子,我们这里也不能免俗。简单来说,我们考虑如何交换两个对象:
最基本的做法是,我们可以swap(a, b),标准库有一个经典的三赋值实现,这很容易理解。
然而问题来了,如果这个实现不是我们想要的呢?
Situation——定制点
一个典型的情况是,我们要交换的对象是pimpl的:
pimpl对象
PIMPL(pointer to implementation,指向实现的指针)是一种C++当中的编程技巧,在类的公开接口中不包含具体实现,而是使用指针指向一个实现类,而实现类可以在分离的翻译单元中进行开发。它的原理是,指针可以指向不完整类型(因为指针指的是被指对象首地址,而不需要知道对象具体内存情况),这样我们在定义中使用一个前置声明,就可以把实现扔出当前翻译单元了:
// in header file
class widget {
public:
    widget();
    ~widget();
private:
    class impl;
    impl* pimpl;
};

// in implementation file
class widget::impl {
    // :::
};
这样就形成了所谓的“编译防火墙”:对实现类impl的改动不会引发使用了对应header的文件的重编译,极大地减轻了编译期的依赖;对类成员布局的修改,也不会破坏接口的ABI。
对于这样一个对象,我们如果调用三赋值的swap会发生什么呢?那会引发三次深拷贝,因为pimpl类型通过指针管理实际对象,显然这里调用的拷贝构造(赋值),我们会把它实现成深拷贝的。而这里我们实际需要做的是交换pimpl指针就可以了。这种情况下,我们应该自己去实现一个特殊的、高效的swap(widget&, widget&)函数,然后调用这个实现。
也就是说,出现了这样一种情况:我们希望对同一个函数名的调用,会根据不同的条件(主要是特定类别参数)实际调用不同的合适实现。 这样的函数调用点,我们就称之为定制点。它定制的是处理不同的实参时,函数不同的实际表现。
怎么做呢?容易想到两种思路:
Method 1——模板特化 ×
最容易想到的就是给对应函数直接添加特化,然而这并不总是有效。
原因是函数模板无法偏特化,见下例:
namespace My{
	struct A{};

	template<typename T>
	struct B{};
}
template<>
void std::swap<::My::A>(::My::A& a, ::My::A& b)
        noexcept(__and_<is_nothrow_move_constructible<::My::A>, is_nothrow_move_assignable<::My::A>>::value)
		{} // ok

template<typename T>
void std::swap<::My::B<T>>(::My::B<T>& a, ::My::B<T>& b)
	noexcept(__and_<is_nothrow_move_constructible<::My::B<T>>, is_nothrow_move_assignable<::My::B<T>>>::value)
		{} // ill-form
这里对My::A的特化是成功的,然而My::B<T>则不行,因为这属于一种偏特化,而函数模板是无法进行偏特化的。因此像hash<user_type>一样添加模板特化的方式,并不是我们需要的答案。
既然函数模板不能偏特化,而一般我们要偏特化函数模板的时候,都是通过functor(仿函数,它的本质是类,可以偏特化)去实现的。那么这里采用同样的手法实现可不可以呢?这也是不行的。因为像swap这样,我们已经有了一个作为函数的实现,如果再出现一个作为对象实现的functor和它同时可见,那么重载决议会失败。
Method 2——ADL √
第二个方法则是借助ADL(Argument-dependent Lookup,实参依赖查找)机制。
什么是“ADL”
我在这里默认这篇文章的读者对模板编程已经有了初步的了解。不过以防万一,我们还是解释一下“ADL”是什么。
在无限定函数调用中,我们会将实参所在命名空间可见的重载也加入候选集——因此称之为实参依赖查找(ADL) 。例如,在如下代码中,有限定(即使限定为空也算)调用::f(x)会找到调用点可见的f(T),而无限定调用会引入a所在的namespace local中的f(A):
namespace local{
	struct A{};
	void f(A){
		std::cout<<"local\n";
	}
}
template<typename T>
void f(T)
{
	std::cout<<"global\n";
}
int main()
{
	local::A x;
	f(x); //local by ADL
	::f(x); //global
	return 0;
}
此时加入候选集的void f(A)由于是更好的匹配,所以得到了调用。当然,这要求它的确比f(T)更为特殊。
那么ADL会在什么时候发生呢?
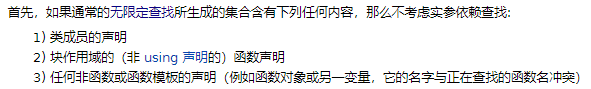
image.png
——简而言之,如果ADL之前在局部作用域就找到了函数声明,或者找到任何非函数的声明,就会拒斥ADL的发生。
我们知道,对于具体类型参数所编写的一个函数,总是比模板的一般重载特殊的。放在一起看,一般是:
namespace std{
	template<typename T>
	return_type foo(T arg); // 1, default implementation
}

namespace My{
	return_type foo(my_type arg); // 2, user implementation
}
那么,如果让这两个重载都在调用点处可见,不是就能满足我们的需求了吗?当我们有一个“更好”的用户定义实现的时候,ADL会让它被发现,然后成为最佳匹配函数被调用;当我们没有给出user implementation的时候,default implementation是可见的,会成为兜底的调用。
为了让这个机制生效,我们的调用就需要是:
using std::foo;
foo(x);
这样std::foo会被显式引入后找到;而My::foo如果存在,由于是非限定调用,会通过x的ADL被找到。——这种先using后调用的方案,我们下文会称之为两步法。
对于我们的user implementation,可以通过hidden friend function去实现。相比于普通的友元函数,使用hidden friend的好处在于它仅供ADL使用,无法被外部调用找到:
namespace My{
	struct A{
	private:
		friend void foo(A); // can be found only by ADL
	};
}
于是我们就可以这样去解决我们的问题:
namespace My{
	struct A{
	private:
		friend void swap(A&, A&)
		{
			// ...
		}
	};
	struct B{};
}

int main()
{
	using std::swap; //intro
	My::A a1, a2;
	swap(a1, a2); // called My::swap(A&, A&)
	My::B b1, b2;
	swap(b1, b2); // called std::swap
	return 0;
}
到此为止,我们初步解决了函数定制派发的问题。但它还不是真正的“定制” 7。
2 CPO(定制点对象)
2.1 “定制”的含义
之所以说前面的解决方案没有实现真正的“定制”,是因为它只提供了ADL实现和库实现之间的选择,这肯定不足以称之为真正“定制”了一个功能。
那么什么是我们需要的“定制”呢?
真正的定制,应该能够允许我们对一个宏观的行为,根据调用者的不同而因地制宜地实现不同的具体表现6 ,而不是仅限于在用户实现和库实现之间做出选择。
比如,我们现在需要定制一个begin函数,它的功能是对一个范围获取它的首地址(指针/迭代器)。这就会涉及到多种情况:
- 如果这个范围是个native array,那么得到的应该是它的首元素地址;
- 如果这个范围是一个标准或自定义的容器,例如
std::array等,那么它提供了成员函数xxx.begin(),我们应该调用它并返回; - 如果这个范围是某个我们自定义的东西,但通过ADL的方式在命名空间内提供了
begin(xxx)的实现,应该得到调用的则是这个实现。
可以看出,一个功能的具体实现可以是相当不同的。真正的定制应该能够顺利地处理这些不同情况。
写成伪代码的话,大概是这样:
auto begin(T x)
{
	if is_array(x)
		return x;
	else if is_container(x)
		return x.begin()
	else if has_adl_begin(x)
		return begin(x)
	else
		fail
}
但其实有一部分功能在我们的定制时是不可控的,那就是通过ADL查找找到的重载,我们怎么能够保证它提供的实际作用是我们想要的呢?比如begin,我们希望它是一个指向range头的指针或迭代器。然而它是否也可能是一个开始某个异步任务的命令,并且返回一系列动作的结果呢?
所以真正的定制还需要满足第二个条件:
在定制点处就检查用户提供的重载是否符合预期,并决定是否启用它。
特别地,在C++20时代,由于有了concept和requires,我们还可以把“不符合预期”甚至“实参完全无法实现该功能”的错误,在编译的早期就用human-friendly的形式产生报错。这也是我们所希望的。
2.2 交给ADL+重载决议?
我们前文所提出的“两步法”显然不足以实现如此(甚至需要更加)复杂的逻辑,但在这个基础上继续扩充,是否可能实现我们的目的呢?
就是说,既然我们要实现更加复杂的派发,那就添加更多、或者更复杂的库函数模板重载不就好了吗?更复杂的派发逻辑,只是意味着我们需要更复杂的重载决议罢了。只要能够封装到两步法中的
using foo;
所代表的库实现中去,上面的if-else再复杂,都不会给用户添加使用负担。
核心逻辑是,把“两步法”封装到库实现去,再复杂的逻辑都不是问题。
比如标准库的std::distance,针对迭代器是否可以随机访问,就有两种不同的实现:
// 输入(非随机访问)迭代器版本
  template<typename _InputIterator>
    inline _GLIBCXX14_CONSTEXPR
    typename iterator_traits<_InputIterator>::difference_type
    __distance(_InputIterator __first, _InputIterator __last,
               input_iterator_tag)
    {
      // concept requirements
      __glibcxx_function_requires(_InputIteratorConcept<_InputIterator>)

      typename iterator_traits<_InputIterator>::difference_type __n = 0;
      while (__first != __last)
	{
	  ++__first;
	  ++__n;
	}
      return __n;
    }

// 随机访问版本
  template<typename _RandomAccessIterator>
    inline _GLIBCXX14_CONSTEXPR
    typename iterator_traits<_RandomAccessIterator>::difference_type
    __distance(_RandomAccessIterator __first, _RandomAccessIterator __last,
               random_access_iterator_tag)
    {
      // concept requirements
      __glibcxx_function_requires(_RandomAccessIteratorConcept<
				  _RandomAccessIterator>)
      return __last - __first;
    }
这种模板的复杂是不会外溢到使用当中的,如果能够实现,那就非常完美了!况且在C++17标准后,if constexpr和constexpr函数的功能非常强大,我们上面的begin(T x)是很容易实现的!比如这样(我们可以形象地称之为“派发器”):
template<__maybe_borrowed_range _Tp>
requires is_array_v<remove_reference_t<_Tp>> || __member_begin<_Tp> || __adl_begin<_Tp>
constexpr auto
begin(_Tp&& __t) const noexcept(_S_noexcept<_Tp&>())
{
	if constexpr (is_array_v<remove_reference_t<_Tp>>)
	{
		static_assert(is_lvalue_reference_v<_Tp>);
		return __t + 0;
	}
	else if constexpr (__member_begin<_Tp>)
		return __t.begin();
	else
		return begin(__t);
}
然后我们就只需要把那些很麻烦但并不会让麻烦外溢的is_array_v、__member_begin……补齐就好了
……吗?
NO! 这个函数不会像我们想象的一样得到调用!
原因是通过ADL找到的函数往往都更为特殊! ,它们会永远优先于我们的上述“派发器”重载被调用。原因是在实参所属的namespace中,我们明确知道它的类型,所编写的实现往往都更特殊。
函数重载决议
函数重载决议是一个很复杂的过程,但简单来说:非模板的函数重载比模板的更特殊,有约束的函数重载比无约束的更特殊,需要实参隐式转换更少的函数更为特殊。
而最后,如果有相比于其他重载都更特殊的重载,那么它成为“最佳匹配函数”而被选中调用。
例如:
namespace User
{
	struct A {};

	void foo(A); //non-template, more specific √
}
namespace lib
{
	template<typename T>
	void foo(T arg); //templated, more general
}

int main()
{
	User::A a;
	using lib::foo;
	foo(a);
	return 0;
}
这就导致了,ADL重载拥有了超过定制逻辑的最高优先级,它如果存在就总是会生效。这与我们的“定制”需求完全背道而驰。我们无法定制优先于ADL重载的派发,甚至也无法检查ADL重载到底是否是正确的。
2.3 用functor来阻止ADL
但是正如上文的begin(_Tp&& __t)实现的一样,ADL重载在我们的“派发器”中是可以自由安排的,只要进入“派发器”当中,各种逻辑都可以灵活实现。
所以我们现在面临的问题就剩下一个了:
如何屏蔽ADL?
所幸这种方法在现有语言机制里是存在的:
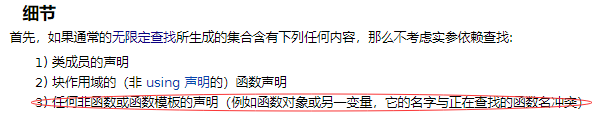
image.png
如果无限定调用找到了非函数的声明,那么ADL就不会发生了!
……非函数的声明?
Functor!
我们用functor去实现就好了呀!
由于需要保持写法一致,那么我们需要使用functor的实体——也就是函数对象(以下代码来自libstdc++)5:
inline namespace __cust
{
	inline constexpr __cust_access::_Begin begin{};
	// ...
}
namespace __cust_access // in std::ranges
{
	struct _Begin
	{
		// ...
	public:
		template<__maybe_borrowed_range _Tp>
		requires is_array_v<remove_reference_t < _Tp>> || __member_begin <_Tp>
			|| __adl_begin <_Tp>
		constexpr auto
		operator()(_Tp &&__t) const noexcept(_S_noexcept<_Tp &>())
		{
			if constexpr (is_array_v < remove_reference_t < _Tp >>)
			{
				static_assert(is_lvalue_reference_v < _Tp > );
				return __t + 0;
			}
			else if constexpr (__member_begin < _Tp >)
				return __t.begin();
			else
				return begin(__t);
		}
	};
}
事实上,这正是标准库中一个完整的CPO的实现。由于它是一个函数对象,所以当我们:
using namespace std::ranges;
begin(x);
的时候1 ,就只会正确找到ranges::begin啦!然后它内部封装好了我们之前所预期的复杂的定制过程。
所以CPO本质上,就是一个能够正确解决复杂定制问题的functor对象。
来看一眼标准的定义,如下:
1 A customization point object is a function object (20.14) with a literal class type that interacts with program-defifined types while enforcing semantic requirements on that interaction.
2 The type of a customization point object, ignoring cv-qualififiers, shall model semiregular (18.6).
template<class T>
concept semiregular = copyable<T> && default_initializable<T>;
现在我们可以总结一下CPO解决的问题了:2
- 它能够在编译期对于简单的无限定调用,根据实参的不同情况进行判断,并转发到正确的实现;
- 它能够检查实参与ADL重载(若存在)是否符合语法要求,并在需要的时候报错。
3 Niebloid对象
花了这么久介绍CPO,std::ranges中的函数调用和它有什么关系?
首先,这些算法大多都需要派发到标准算法去实现,例如sort、kth_element等等,不存在视情况转发的需求。
那我们看看实际情况好了。当我们用类似的两步法,using namespace std::ranges之后去非限定调用一个ranges算法,会发生什么?
注意到如果我们实参使用了STL Container等,那么两步法会通过ADL引入namespace std当中的同名函数,因此这里就需要进行重载决议了,我们举一些例子:
// std
template< class InputIt, class UnaryFunction >
UnaryFunction
for_each( InputIt first, InputIt last, UnaryFunction f );
// std::ranges
template< std::input_iterator I, std::sentinel_for<I> S, class Proj = std::identity,
          std::indirectly_unary_invocable<std::projected<I, Proj>> Fun >
constexpr ranges::for_each_result<I, Fun>
for_each( I first, S last, Fun f, Proj proj = {} );

// std
template< class InputIt, class OutputIt >
constexpr OutputIt
copy( InputIt first, InputIt last, OutputIt d_first );
// std::ranges
template< std::input_iterator I, std::sentinel_for<I> S, std::weakly_incrementable O >
requires std::indirectly_copyable<I, O>
constexpr ranges::copy_result<I, O>
copy( I first, S last, O result );
有没有注意到什么?std当中的重载普遍比std::ranges当中的更为特殊! 这是因为std::ranges当中的算法普适性更强——虽然派发的终点是一样的,但是接收的ranges可能有不同的情况,std::ranges中的算法可以全部接纳他们并且做正确的调整以适配到实际算法的调用!
但由于这一点,跟我们之前所面临的情况一样,ADL查找会使得std::ranges当中的重载劣于std当中的,从而无法被调用。
所以这里我们需要做的事情就是:屏蔽掉ADL查找!
这种std::ranges中的需要屏蔽ADL的算法调用,我们根据提出者niebler的名字,命名为:Niebloid。
然后……我们是不是刚发明了一个现成的工具来着?
对!就是CPO。所以当前版本的C++标准(20),就选择了使用CPO来解决这一问题。
把上述对象实现成CPO的形式,非预期的ADL查找就被解决啦!比如std::ranges::copy就实现如下:
  struct __copy_fn
  {
    template<input_iterator _Iter, sentinel_for<_Iter> _Sent,
	     weakly_incrementable _Out>
      requires indirectly_copyable<_Iter, _Out>
      constexpr copy_result<_Iter, _Out>
      operator()(_Iter __first, _Sent __last, _Out __result) const
      {
	return ranges::__copy_or_move<false>(std::move(__first),
					     std::move(__last),
					     std::move(__result));
      }

    template<input_range _Range, weakly_incrementable _Out>
      requires indirectly_copyable<iterator_t<_Range>, _Out>
      constexpr copy_result<borrowed_iterator_t<_Range>, _Out>
      operator()(_Range&& __r, _Out __result) const
      {
	return (*this)(ranges::begin(__r), ranges::end(__r),
		       std::move(__result));
      }
  };

  inline constexpr __copy_fn copy{};
所以,现在我们可以给Niebloid下一个定义了:
Niebloid是指需要屏蔽掉ADL查找才能正确得到调用的一系列ranges算法。
而它和CPO的关系是:
目前所有主流编译器都使用CPO去实现Niebloid。
CPO的弊病
前面我们提到了,CPO一个重要的作用就是帮我们筛选“正确”的重载。然而它真的能够实现吗?
还是用begin的例子来看,研究下__adl_begin到底做了哪些检查:
    template<typename _Tp>
      concept __adl_begin = __class_or_enum<remove_reference_t<_Tp>>
	&& requires(_Tp& __t)
	{
	  { __decay_copy(begin(__t)) } -> input_or_output_iterator;
	};
啊!所以其实它只能检测语法而非语义。这似乎是很自然的事情,但引发了一个大问题:我们怎么就能保证这样的函数真的做了我们想要begin去做的事情呢?
一种可能的糟糕情况
比如我们当然可以有一个begin()函数,调用它会发起一个网络连接,接收一串数据并存储,然后返回数据容器的begin迭代器。这完全是合规的。
如果这种事情真的发生了,不会有任何报错,也不会有任何提示。它就是会产生一个错误的逻辑,极难排查。
当然你可以说:
用户定制功能属于库的一部分。程序员有责任对此注意并负责。
当然,我们很容易意识到begin是一个会具有特殊含义的名字,于是可以规避它。但当sender/receiver加入标准库以后呢?当更多的第三方库杂糅在一起以后,并且都使用了CPO来解决问题呢?
CPO方案正在做的事情,是引入一种全新的耦合形式——我将它称之为名字耦合。仅仅是名字和语法要求的匹配,就能够在我们不经意的情况下扰乱函数调用的派发。如果这种情况变的普遍,那么产生意外的可能性就会急剧升高。
我们可不可以审慎的考察我们对于函数名字的使用并且尽量让它符合库的预期?当然可以,但这没有从根本上解决问题,除非你用的库既简单、又清晰,否则当CPO的数量增多的时候,总有失察的风险。——况且,你不会知道第三方库作者的脑子里在想些什么的。
那么我们就需要在为我们的对象设计函数时就需要多一份这种额外的注意:这个名字是否在哪里具有特殊的含义?我是否应该保留它?
当然,如果这样注意了,按现在大家对名字的使用数量,暂时不会有什么大的风险。但是问题是:当我们需要开始考虑这种额外的小心时,证明有些事情就已经不对劲了。
所以,如果有更好的方法,为什么不采取呢?
新方案1 - tag_invoke
tag_invoke就是我所说的——更好的方法。
就像重载一样,CPO的本质也是静多态。那么回想一下我们原本的C++语言系统中,静多态都是怎么实现“定制”的?
当我们要给一个自定义类型提供hash算法,特别是以供其他操作(例如std::unordered_set)调用时,我们会怎么做?
是这样的:
template <>
struct std::hash<User::A>
{
	std::size_t operator()(const User::A& arg) const
	{
		// ...
	}
};
当我们要给优先队列指定一个偏序的时候,形式是这样的:
namespace User{
	struct my_type;
	struct my_type_greater : std::binary_function<my_type, my_type, bool>
	{
		bool operator()(const my_type& lhs, const my_type& rhs) const
		{
			// ...
		}
	};
}
std::priority_queue<User::my_type, vector<User::my_type>, User::my_type_greater> pq;
可以看到,以上两种方式大相径庭,但它们都有一个共同点:必须显式指明给某种使用机制去使用。
我们既不可能在User空间里声明一个hash<user_type>functor然后让它自动生效,也不可能让my_type_greater声明过后就自动生效。前者需要我们明确地给std::hash添加特化,后者需要我们把策略明确地写入到priority_queue的模板实参当中去。
只有当我们明确地让某个机制去使用我们代码当中的某个实体,这个实体才有可能被它使用。——这是上述传统用法与CPO最大的不同;反之,这种“无需授意”的使用,也是CPO“名字耦合”最大的不安全来源。
tag_invoke方案解决了这一问题:它通过一种“显式的注册机制”引入了这种对于“主动性”的要求,并且把CPO对于global name的占有缩小到了仅有一个。
简而言之,这个方案是这样的:
在CPO方案里,假设我们有一个叫foo(arg0, arg1)的CPO在库中,那么我们user namespace当中的foo(arg0, arg1)也就此被该用法占据了。只要我们用符合该CPO的constraint的形式声明了,那么它就可能被自动的纳入std::foo的派发考虑当中。像这样:
namespace Lib
{
	namespace detail
	{
		template<typename T>
		void foo(T, T)  // default implementation
		{
			std::cout << "Lib define." << std::endl;
		}

		struct cpo_foo
		{
			template<typename T>
			void operator()(T arg0, T arg1) const // dispenser
			{
				foo(arg0, arg1); // distribute
			}
		};
	}

	inline detail::cpo_foo foo{};
}

namespace User
{
	struct A
	{
		friend void foo(A, A)  // ADL implementation
		{
			std::cout << "User define." << std::endl;
		}
	};

	struct B {}; // No ADL implementation
}
问题的关键就是在于,dispenser可以直接去找到User中暴露的foo,这很不安全。而tag_invoke方案所做的,就是把cpo_foo的派发约束在“用户明示用于CPO的实现”中。这要怎么明示呢?我们上面的std::hash模板特化已经给出了答案:把所有候选注册成同一个模板的重载。而对标std::hash模板的框架,我们这里称之为tag_invoke。
CPO是通过类型+对象实现的,这点给予了tag_invoke很大的便利:tag_invoke是一个函数,他的第一个参数为CPO,仅仅用作“标签”,标明当前tag_invoke派发或调用的是什么函数,后随该函数的实参。原本的派发器将对foo(arg0, arg1)的调用变为了tag_invoke(foo{}, arg0, arg1)(第一个参数传入重载对应的CPO,以表明当前派发谁),因此不管是Lib还是User中,原本的foo实现,当且仅当我们用于CP的时候,将其定义为tag_invoke(Lib::foo{}, arg0, arg1)。由于CPO不存在转型问题,所以重载决议根据第一个实参就控制在了全部foo的tag_invoke实现上。
将上例用tag_invoke改写,完整例子如下:
#include <iostream>

namespace Lib
{
	template<auto &tag_name>
	using tag_t = std::decay_t<decltype(tag_name)>; // tool for parsing CPO's type.

	namespace detail
	{
		struct cpo_foo
		{
			template<typename T>
			void operator()(T arg0, T arg1) const // dispenser
			{
				tag_invoke(cpo_foo{}, arg0, arg1); // distribute
			}
		};

		template<typename T>
		void tag_invoke(cpo_foo, T, T)  // default implementation
		{
			std::cout << "Lib define." << std::endl;
		}
	}

	inline detail::cpo_foo foo{};
}

namespace User
{
	struct A
	{
		friend void tag_invoke(Lib::tag_t<Lib::foo>, A, A)  // ADL implementation
		{
			std::cout << "User define." << std::endl;
		}
	};

	struct B {};  // No ADL implementation
}

using namespace Lib;

int main()
{
	User::A a;
	foo(a, a);
	User::B b;
	foo(b, b);
	return 0;
}
输出:
User define.
Lib define.
就这样,大量不同global name的独占,变成了一个global name+不同的标签。这本质是一种封装。
我的看法:
CPO在名字使用上的新的、不易察觉的、危险的耦合,让我无法喜欢这个方案。正因如此,tag_invoke是我目前最喜欢的解决办法。相比于下面要叙述的语言机制方案,它也足够保守:如果能够通过技巧去解决问题,还是尽量避免对语言进行改动,尤其是增加新的关键字用法。略微增加库的代码量不是问题,只要它有合理的对外屏障;但提出新的关键字总是一个需要谨慎的问题。
新方案2 - 定制点函数
现在我们去考虑一些更本质的问题——我们之前提到过,有没有觉得“定制点”和一些C++中已经存在的东西非常的相似?
“根据不同的对象把同一功能(接口)派发给不同的具体实现”——这不就是虚函数嘛!
从本质上说,我们可以认为定制点对象就是静态、非类的虚函数4,那么自然有一种想法,就是把它的实现通过“虚函数”一样的新机制去实现,不再需要我们为了一些ADL、functor之类的tricky method去绞尽脑汁了。
P2547R0 - Language support for customisable functions (open-std.org)这个提案就给出了这样的建议,我们直接把virtual、override、=0……这些类继承当中的东西挪到非类的函数调用中来,把具体细节让编译器去实现,不就好了么?
比如这样3:
namespace shapes {
	template<typename T>
	virtual float area(const T& shape) noexcept = 0;
}
namespace mylib {
	struct circle {
		float radius;
	};
	inline float shapes::area(const circle& c) noexcept override {
		return c.radius * c.radius * std::numbers::pi_v<float>;
	}
}
当然,该提案只是目前借鉴了虚函数的语法,但它和虚函数有最大的区别:如我们前面一直做的一样,定制点函数是可以编译期解决重载的,它并不会真正引入“虚表”机制而带来运行时开销!
我的看法:
引入新的关键字、新的语言机制总是要慎之又慎。能够通过库内手法去解决的问题,尽量不要这样做。事实上,LWG这些年一直也在秉持这种态度,我认为是正确的。因为在库内通过tricky method去解决问题,即使会很麻烦,这种麻烦并不会外溢到使用时,是我们可以忽略的。而对语言的改变,不免会带来一些不可忽略的弊端——哪怕是最简单的关键字冲突。
总结
作为后来者,本文在很大程度上参考了下文罗列参考文献当中的第一篇,这篇文章非常详实,并且涉及了许多细节问题,十分建议拓展阅读。然而在关键的逻辑叙述上,本文与之存在很大不同。该文与许多其他分析CPO的文章,都把“两步法的繁琐和易错”当做一个主要的问题(可能是因为,niebler也这么认为了吧~),但私以为这完全不涉及问题的核心。CPO解决的问题核心如文中所说,是:两步法没有解决真正的“定制”问题,它只支持很简陋的“ADL优先”逻辑。因此,本文重新以该角度切入,引出了CPO和niebloid的发明。
除了对CPO和niebloid这两个语言技术、模型的了解外,它们引出的对于“静多态”的思考,同样是值得进一步研究的:tag_invoke的本质就是std::hash的基于特化的多态;定制点函数的本质就是虚函数的基于语言机制的多态。那么还有没有其他的静多态手法可以用于解决这个问题呢?值得思考。
参考文献
本文主要的参考文献是:
如何理解 C++ 中的 定制点对象 这一概念?为什么要这样设计? - 知乎 (zhihu.com)下Mick235711的回答,而它的主要参考文献可能来自Niebloids and Customization Point Objects,这篇文章已经整理的比较不错了。
如果想要多一些思考,我推荐继续阅读Barry的另一篇文章:Why tag_invoke is not the solution I want,它提供了多种“定制”方案的比较思路。
tag_invoke的提案在p1895r0.pdf (open-std.org);
定制点函数(关键字支持)的提案则是P2547R0 - Language support for customisable functions (open-std.org)。